超大规模库时代的 QuickShape筛选
蒂姆·克内汉斯、史蒂夫·迪克森、尼克·博伊尔斯、段建新、克里斯·冯·巴根、沃洛迪米尔·巴宾、史蒂夫·杰罗姆、马特·雷帕斯基


现成的化学库规模仍在迅速扩大,而针对药物靶点的创新化合物需求则处于历史最高水平。尽管基于三维Shape 的方法通过寻找拓扑结构不同但形状相似的先导化合物,为富集活性化合物提供了一种有效途径,但对于筛选 超大规模化学库而言,其硬件要求可能变得难以承受。 本文将基于一维(1D)药效团的指纹技术与基于GPU的Shape 筛选 进行比较,从已知活性物质的富集效果和计算速度两个方面进行评估。
1D方法不仅能保持与Shape 筛选 非常接近的富集水平,且回收的活性物质重叠度很高,还能提供独特的阳性结果。 此外,该方法可在普通笔记本电脑上于数日内对数十亿个分子进行筛选 筛选,且所需存储空间仅为传统方法的百分之一。通过结合一维和三维方法,我们开发了一种名为 QuickShape 的自动化分阶段工作流程,可对规模达数百亿分子的化合物库进行高效的三维Shape 筛选。在超大规模化合物库的新时代,该工作流程是基于配体的筛选 解决方案的绝佳选择。
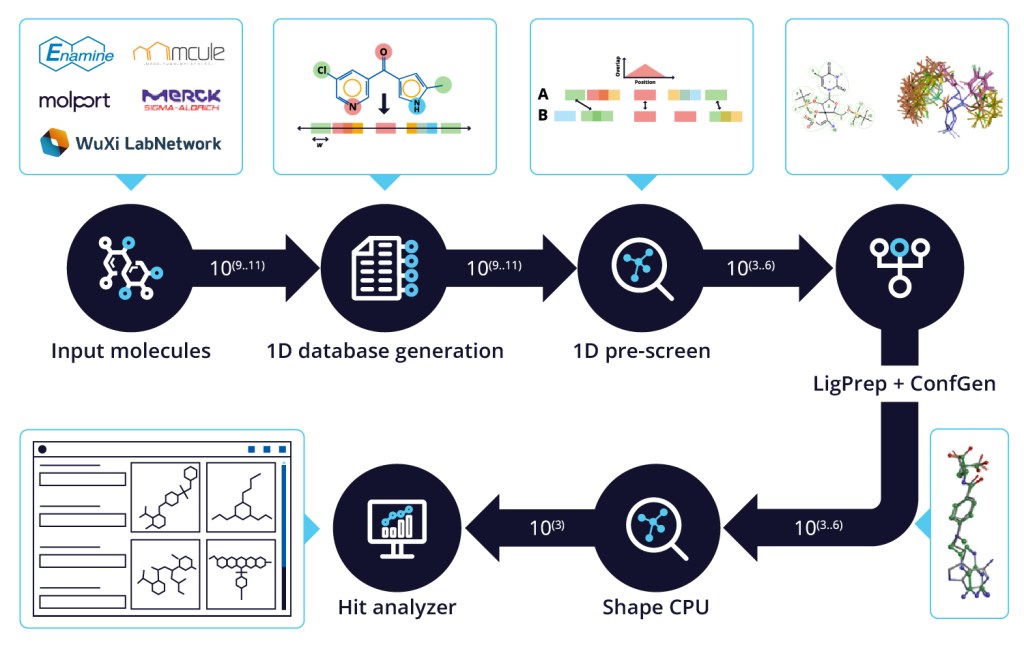
1D指纹技术可在QuickShape工作流程中,于数小时内对Enamine REAL进行预筛选
QuickShape 是一个级联的筛选 工作流,首先使用一维药效团指纹筛选 ,随后使用Shape 筛选 。对于每个分子,系统会识别其相应的质子化状态和互变异构状态下的药效团,并将其投影为指纹向量。药效团点之间的距离即为药效团之间的键数。
该过程每处理100万个分子大约需要1 CPU小时。与同等规模的Shape GPU数据库相比,生成的数据库所需的存储空间仅为其百分之一。一个包含65亿个化合物的数据库仅占用400 GB空间。
相似性是通过比较分子A和分子B之间等效药理基团的重叠程度来定义的:
Sim(A, B) = Overlap(A, B)/max[Overlap(A, A), Overlap(B, B)]
相似性比较速度极快,且支持并行处理。使用一台10核计算机,14小时内即可筛选65亿种化合物。
通过Shape 筛选 对 1D筛选 中的命中结果进行筛选,最终生成的苗头化合物 列表可通过Maestro 中的苗头化合物 分析面板,基于多样性、特定的药理活性基团标准及性质过滤器进行分析。整个工作流可在笔记本电脑上运行,耗时仅需几天。
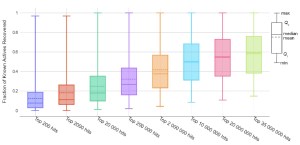
与Shape 筛选相比,1D筛选 提供了类似的富集效果
首先,我们利用DUD-E数据集中的活性化合物(该数据集基于Enamine REAL的14亿个分子构建),通过将1D相似性与Shape 的富集结果进行对比,验证了1D相似性的有效性。其中,多样性最高的五种活性化合物被用作探针。两种方法对已知活性化合物的富集结果非常接近。 在前20万个匹配结果中,所有靶点均鉴定出了活性化合物,这表明仅使用1D筛选 便已具有实用价值。需要注意的是,实际富集度可能远高于此,因为Enamine REAL数据库中很可能还存在其他未知的活性化合物。
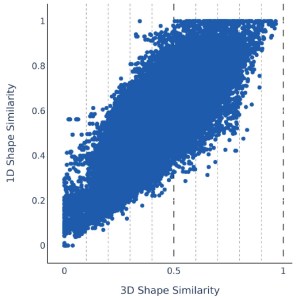
1D筛选 和Shape 之间相关性良好,且内容高度重合
其次,我们确保 1D筛选 能够检索到与Shape 相同的分子,这通过前几项检索结果之间的重叠百分比来体现。 在 1D筛选 返回的前 2000 万条结果中,我们发现其中至少有 50%、平均有 90% 与Shape 筛选 返回的前 20 万条结果重合。仅就前 20 万条结果而言,平均重合率已超过 60%,这表明只需运行Shape 计算量的百分之一即可。
1D相似度得分与Shape 相似度呈高度相关,R²值为0.65。这表明,1D筛选 能够在保持类似性能的同时,将Shape 的比较次数减少84%。
应将QuickShape及其组成技术结合使用
由于Shape 与1D筛选 (1DSIM)之间的富集结果相似,但相关性与重叠度均未达到100%,因此我们通过计算以下指标,可视化了1D筛选 对恢复活性物质的独特贡献趋势:
#actives1DSIM – 2 个 #actives1DSIM ∩Shape
在此图表中,所有大于0的数值均表示:由1D筛选 唯一检出的活性化合物数量,至少是重叠命中数量的两倍。 与前面的图表一样,每种方法返回的分子越多,重叠程度就越大,分布也会向0以下偏移,从而使这些分子能够被QuickShape工作流所识别。然而,在所有区间中,仍有大量分子位于0以上或接近0。这表明1D筛选 能够独立提供有价值的苗头化合物 信息,因此通常建议对两种方法中排名靠前的分子进行深入研究,以提高发现新型苗头化合物 的可能性。
