分子对接 以及得分
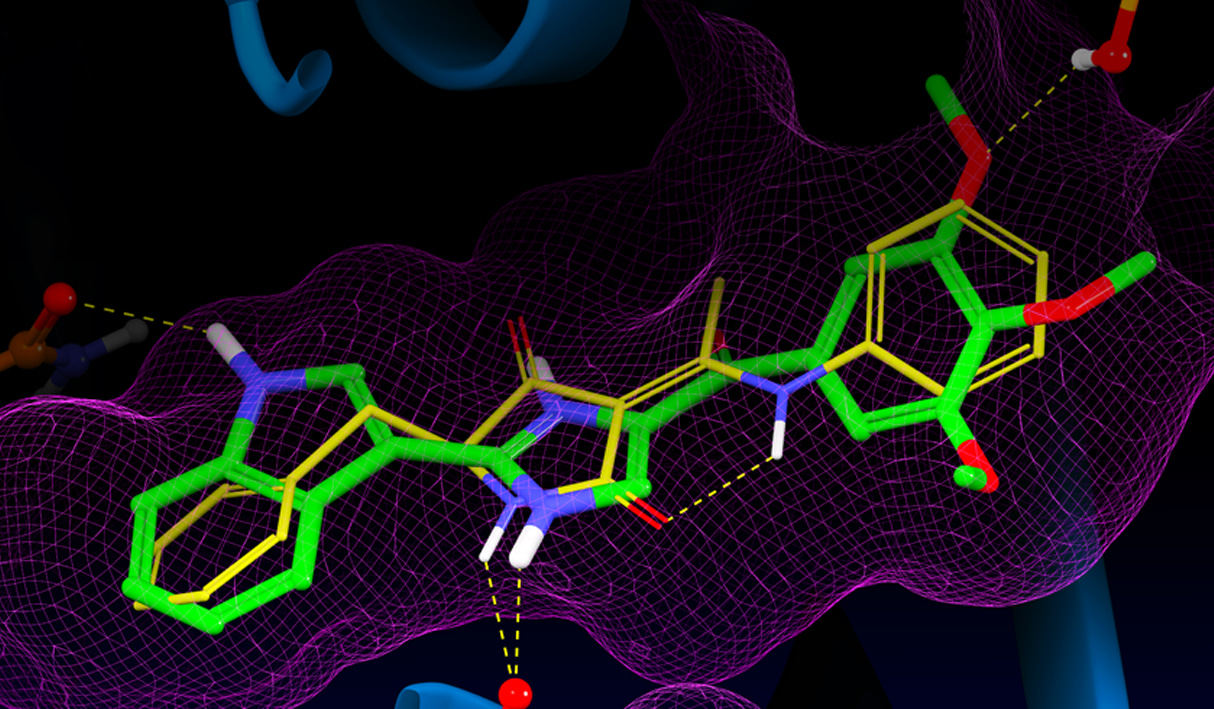
虚拟筛选 已被证明是一种非常成功的方法,可用于寻找配体初选物,并协助先导化合物 优化 在基于结构的药物设计 项目中开展工作。通过分子对接 将大量化合物库映射到靶点 受体的一个或多个高分辨率结构上,通常只需对较少的化合物进行实验筛选,即可识别出有潜力的先导化合物 优化 候选物。 除了识别可能与蛋白质结合良好靶点 的小分子外,分子对接 方法还被应用于多种场景,例如多肽和大环的构象预测、蛋白质-配体复合物的几何结构预测,以及利用自由能微扰 或MM-GBSA等方法构建同系物系列以进行结合亲和力 预测。超越了基于结构的虚拟筛选中常见的刚性受体近似法筛选 ,诱导契合分子对接 协议可预测配体分子对接 对蛋白质结构的影响。
Rigid Receptor分子对接 附带Glide
Glide 分子对接 及评分方法
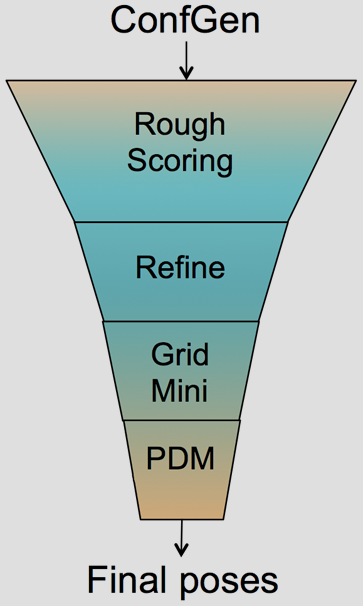
Glide 的HTVS、SP和XP分子对接 方法此前已得到详细描述。1-3Glide HTVS和SP利用一系列分层过滤器,在受体的结合位点区域内搜索配体的可能位置。受体的形状和性质通过网格上的不同字段集来表示,这些字段集能对配体构象提供逐步提高的评分精度。 对配体扭转的穷举枚举会生成一组配体构象,这些构象将在分子对接 过程中进行分析。基于这些配体构象,系统会在配体可及的整个phase 空间内确定性地进行初始筛选,以定位有前景的配体构象。 从初始筛选 选出的构象中,利用OPLS34(Glide 的SP和XP版本)或OPLS2005(GLIDE HTVS),结合距离依赖型介电模型,在受体场中对配体的扭转空间进行精修。 最后,在受体场内对少量构象进行最小化计算,此时配体具有完全的灵活性(即分子对接 最小化或PDM之后)。该过程被称为分子对接 漏斗法,如图1所示。
Glide HTVS 能够以约 2 秒/化合物的速度对接化合物,其以牺牲采样深度为代价换取更高的速度。Glide SP 模式采用穷举采样,是速度与精度之间的推荐平衡方案,每种化合物的处理时间约为 10 秒。Glide XP 模式采用“锚定与扩展”采样方法,并使用不同的 GlideScore 函数形式。其化合物对接速度约为每种化合物 2 分钟。这三种分子对接 模式为大多数情况提供了在速度与精度之间平衡的多种选择。
Glide 使用Emodel1评分函数从给定配体的蛋白质-配体复合物中进行筛选,并使用GlideScore2函数对化合物进行排序,以将强结合化合物(活性化合物)与弱结合或不结合的化合物(非活性化合物)区分开来。Emodel 评分函数主要由蛋白质-配体库仑-范德华能决定,GlideScore 仅作微小贡献。 GlideScore 是一种经验评分函数,旨在最大限度地区分结合力强的化合物亲和力 与结合能力微弱或几乎没有结合能力的化合物。作为一种经验评分函数,它由反映结合过程物理特性的各项组成,包括亲脂-亲脂项、氢键项、可旋转键惩罚项,以及蛋白质-配体库仑-范德华能的贡献。 除上述项外,GlideScore还包含用于考虑疏水包围3的项,即配体从存在大量邻近亲脂性蛋白质原子的区域排挤水分子。如图2和图3所示,在疏水包围区域内形成一个或多个蛋白质-配体氢键,对结合尤为有利。
Glide 分子对接 准确率与数据增强性能
首篇关于 Glide 的文章¹是《药物化学杂志》(Journal of Medicinal Chemistry)有史以来被引用次数第二多的论文(截至2016年2月),许多文献都引用了其在药物发现项目中的应用。Glide能够持续为先导化合物 优化 识别先导化合物,并帮助理解影响蛋白质-配体结合的关键相互作用和脱溶剂化效应,这些能力推动了该工具的广泛采用。 要获得最高质量的分子对接 结果,前提是必须使用由“蛋白质制备向导”(Protein Preparation Wizard)和LigPrep 采用最佳实践方法准备的蛋白质和配体结构。作为对分子对接 方法进行无偏比较的一部分,我们利用Astex5自分子对接 测试集评估了Glide SP在结合模式预测方面的表现,并利用DUD数据集6在虚拟筛选 环境中评估了其富集能力。 所使用的数据集、评估指标及实验流程均遵循在阿纳海姆举行的第241届美国化学学会(ACS)会议上“分子对接 ”及“Scoring Symposium”所规定的条件。⁷
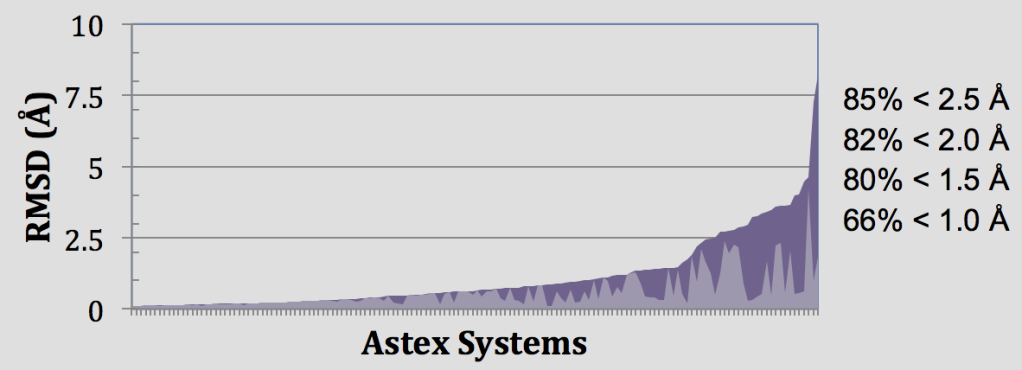
In these retrospective experiments, Glide SP reproduces crystal complex geometries in 85% of Astex cases with < 2.5 Å RMSD as shown in Figure 4. Glide is also effective in enriching screened databases in known actives, beating random selection in 97% of DUD targets and giving an average AUC of 0.80 across all 39 target systems. Early enrichment performance shows on average 12%, 25%, and 34% of known actives are recovered in screening the top-ranked 0.1%, 1%, and 2% of recovered decoys. This enrichment is particularly impressive given the structural similarity between active and decoy ligands in the DUD dataset8 and that docking a ligand with SP Glide takes only about 10 seconds using modern hardware.
| ROC(0.1%) | ROC(1%) | ROC(2%) | AUC | |
|---|---|---|---|---|
| 最佳实践结构 | ||||
| 平均 | 0.12 | 0.25 | 0.34 | 0.80 |
| 中位数 | 0.06 | 0.19 | 0.27 | 0.14 |
| 标准差 | 0.17 | 0.22 | 0.24 | 0.14 |
| 最大值 | 0.82 | 0.88 | 0.88 | 0.98 |
利用Glide 实现“贴近实验”
Glide其广泛的约束条件使人们能够“贴近实验”,据报道,这已成为罗氏制药项目中一个共同主题,这些项目因计算化学而受益匪浅。9氢键约束要求与受体上的特定官能团形成氢键;位置约束可强制对接姿态将特定化学基团置于相对于受体的特定空间区域内;金属约束则可强制配位几何构型。 核心约束条件对于强制实现同系物系列的预期结合模式尤为重要,这在通过MM-GBSA或自由能微扰 预测结合亲和力 时,用于准备对接构象。
分子对接 大环化合物
在分子对接 实验中,高效采样环构象对于再现实验中的结合模式至关重要,特别是对于大环化合物 ,其可能存在数百种低能构象。Glide 依赖于一个庞大的环构象数据库来采样低能态,否则不会对大环系统进行采样。为大环化合物 生成环模板可显著提高天然构象的预测精度。
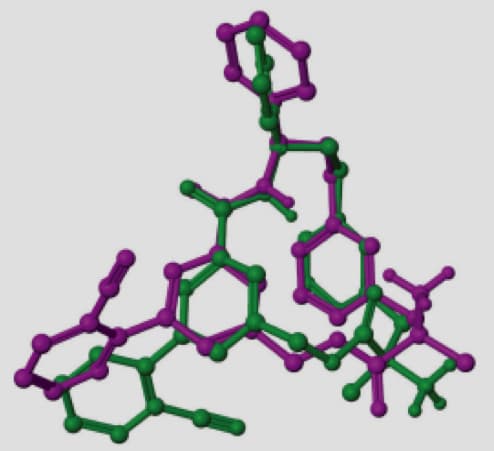
一个典型的例子是本图中所示的来自2QKZ的大环结构,其中天然配体将大环埋入了一个基本封闭的口袋中。要与该口袋结合,需要大环采用特定的构象,从而与配体的羰基和质子化的胺基团形成关键相互作用。 使用该大环的环模板进行对接时,对接构象的RMSD值较低,仅为0.22 Å。若不使用大环环模板,即使大环环原子的RMSD值为0.71 Å(从视觉上看环构象相似),Glide 仍会将环定位在口袋之外,导致RMSD值高达10.23 Å。
分子对接 多肽
随着肽和肽模拟物作为药物应用的日益广泛,准确预测多肽与受体结合复合物的几何构型变得至关重要。Glide 的SP-peptide模式10正是为满足这一需求而开发的,因为将Glide 作为默认方法应用于此类配体时,在基准数据集中的肽样本中,仅有24%能成功通过分子对接 验证。 为提高结合模式预测精度,我们通过系统性地调整所有控制肽构象如何通过Glide 漏斗的参数,对Glide 采样算法进行了修改。应用这些参数的最优组合后,构象预测准确率提升至41%。此外,我们利用了先前报道的Glide 对输入构象的敏感性¹¹,并通过运行多个独立的Glide 任务并合并结果来增加采样量。这使构象预测的准确率进一步提升至53%。 最后,通过对每个预测的构象应用MM-GBSA评分,进一步将准确率提升至58%。这一结果已接近FlexPepDock等穷举法(在该数据集上的准确率为63%)的水平,而计算成本仅为其一小部分(Glide 协议仅需24 CPU小时)。
哪些肽的处理效果最好?
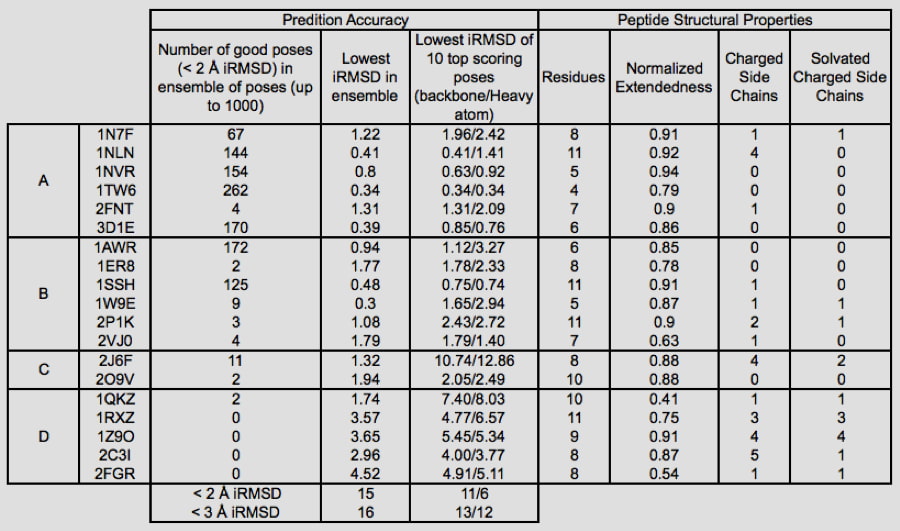
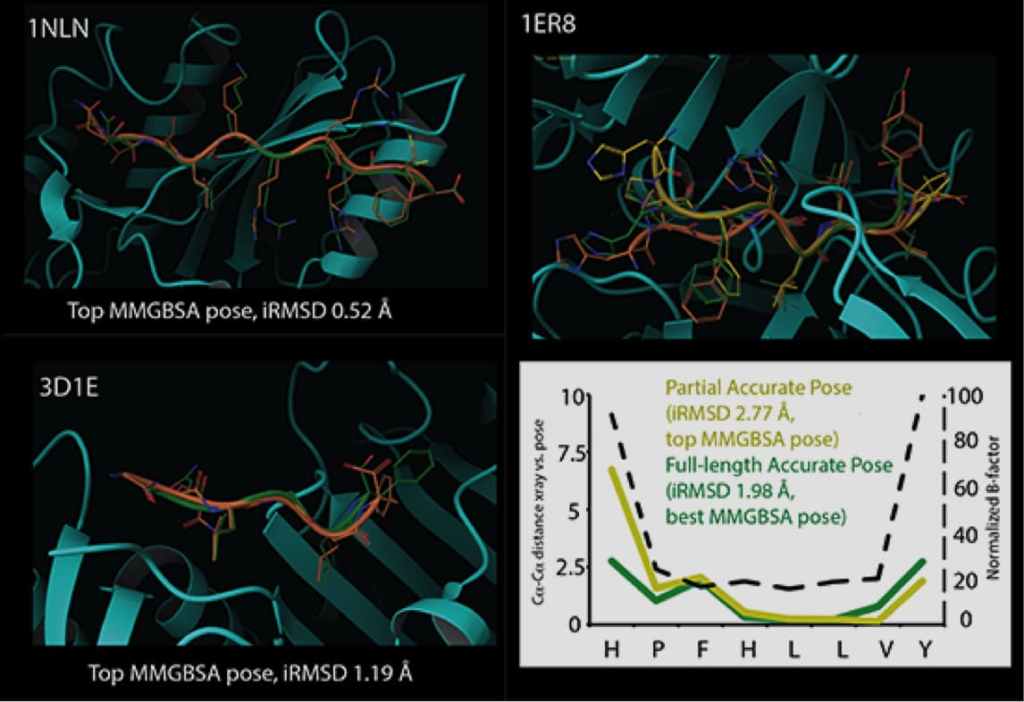
Glide 可对接含有最多300个原子和50个可旋转键的配体。由于许多肽配体可能超过这些限制,这实际上将分子对接 的应用范围限制在约11个残基或更少的肽上。在某些情况下,为了对接更长的肽,有必要将酰胺键固定在反式构型。研究发现,肽的结构特征与其被准确对接的能力之间存在显著的相关性。 例如,我们发现:肽链长度越短、伸展性越高、可电离基团数量越少,肽链正确对接的概率就越大。此外,我们注意到,对于B因子较低的肽段,其预测质量之间存在显著相关性;而B因子较高的区域(通常为N端和/或C端)则会与晶体结构产生显著偏差,这表明这些末端区域的预测结果实际上可能是溶液中的可及态。
诱导配合分子对接
蛋白质复合物的活性位点几何构型在很大程度上取决于结合配体诱导的构象 变化。然而,解析蛋白质-配体复合物的晶体结构需要投入大量时间,且往往难以实现甚至无法实现。Schrödinger的“诱导契合”(IFD)协议通过使用Glide 和Prime,全面考虑受体活性位点内可能的结合模式及相关构象 变化,从而解决了这一问题。 这一独特的流程使化学家能够以极低的成本快速预测活性位点几何结构,即使对于像 hERG 同源模型这样具有挑战性的系统也是如此。
“诱导契合”协议首先使用分子对接 将活性配体与Glide 进行对接。为了生成多样化的配体构象集合,该流程采用了缩小的范德华半径和增大的库仑-范德华截断距离,并在分子对接 步骤中可暂时移除高度灵活的侧链。对于每个构象,随后使用Prime结构预测 通过重新定向附近的侧链来适应配体。然后对这些残基和配体进行能量最小化。 最后,将每个配体重新对接至其对应的低能蛋白质结构中,并根据结合GlideScore和Prime能量的评分函数对所得复合物进行排序。
“诱导契合”(Induced Fit)方法已在实际研究应用中得到了充分完善,无论对初学者还是资深建模者而言,都易于使用。如表3所示,对于那些需要蛋白质构象 发生变化才能实现结合的一系列靶标,“诱导契合”对结合构象的预测效果非常出色。除了适用于广泛系统的默认设置外,“诱导契合”界面还提供了高级选项,可进行自定义以解决更具挑战性的案例。 在台式机上,计算可在数小时内完成;若将计算任务分布到多个处理器上,最快仅需30分钟即可完成。
| 诱导拟合返回的顶级姿势的均方根偏差
|
||||
|---|---|---|---|---|
| 靶点 | 受体 | PDB中配体结构的来源 | 分子对接 诱导配合前的均方根偏差 (Å) |
Induced.Fit 分析后配体的RMSD(Å)
|
| 醛糖还原酶 | 2acr | 1ah3 | 6.5 | 0.9 |
| 抗体 DB3 | 1dba | 1dbb | 7.6 | 0.3 |
| CDK2 | 1buh | 1dm² | 6.4 | 1.1 |
| CDK2 | 1dm² | 1aq1 | 6.2 | 0.8 |
| CDK2 | 1aq1 | 1dm² | 0.6 | 0.8 |
| COX-2 | 3pgh | 1cx2 | 11.1 | 1 |
| COX-2 | 1cx2 | 3pgh | 6.6 | 1.0 (0.51)简体中文(大陆) |
| 雌激素受体 | 1err | 3ert | 5.3 | 1 |
| 雌激素受体 | 3ert | 1err | 2.3 | 1.4 (1.02) |
| Xa因子 | 1ksn | 1xka | 9.3 | 1.5 |
| Xa因子2 | 1xka | 1ksn | 5.3 | 1.5 |
| HIV-RT | 第1rth | 1c1c | 2.5 | 1.3 |
| HIV-RT | 1c1c | 第1rth | 12 | 2.5 |
| 神经氨酸酶 | 1nsc | 1a4q | 3.9 | 0.8 |
| 神经氨酸酶 | 1a4q | 1nsc | 1 | 1.7 |
| PPAR-γ | 1fm9 | 2prg | 9.1 | 1.8 (0.43) |
| PPAR-γ | 2prg | 1fm9 | 9.8 | 3.0 (1.54)简体中文(大陆) |
| 热溶素 | 1kr6 | 1kjo | 1.1 | 1.3 |
| 热溶素 | 1kjo | 1kr6 | 3.5 | 3.2 (1.65) |
| 胸苷激酶 | 1kim | 1ki4 | 4.7 | 0.4 |
| 胸苷激酶 | 1ki4 | 1kim | 0.5 | 1.2 |
4 该RMSD值排除了配体中部分暴露于溶剂的甲基苯基噁唑尾部中的13个原子
5 排除对称二羧酸基团中 6 个原子的 RMSD,这些原子在 IFD 结构中发生了 180° 翻转。“受体”列列出了其他共晶结构中配体所诱导的刚性受体,构象 这些受体发生了变化。在进行“诱导契合”处理之前,分子对接 针对刚性受体的结果要么没有姿势,要么 RMSD 值很高。随着“诱导契合”准确预测活性位点几何结构,配体姿势得到了显著改善。
共价配体分子对接
近年来,人们对设计能与靶点 蛋白形成共价键的药物越来越感兴趣,目前市场上近30%的药物以已知通过共价抑制发挥作用的酶为靶点12。 与靶点 蛋白形成共价相互作用的优势在于能延长生物学效应的持续时间,并有望提高选择性 。共价药物靶向的蛋白质实例包括:与β-内酰胺类和β-内酮类抗生素结合的丝氨酸青霉素结合蛋白(PBPs)、半胱氨酸蛋白酶(如猫肽酶B、 K和S等,这些蛋白酶可被乙烯磺酰基、环氧化物、异噻唑酮和酮酰胺等化学基团共价修饰;以及丙型肝炎病毒(HCV)蛋白酶,其可与博塞普韦和泰拉普韦的酮酰胺基团形成共价键。
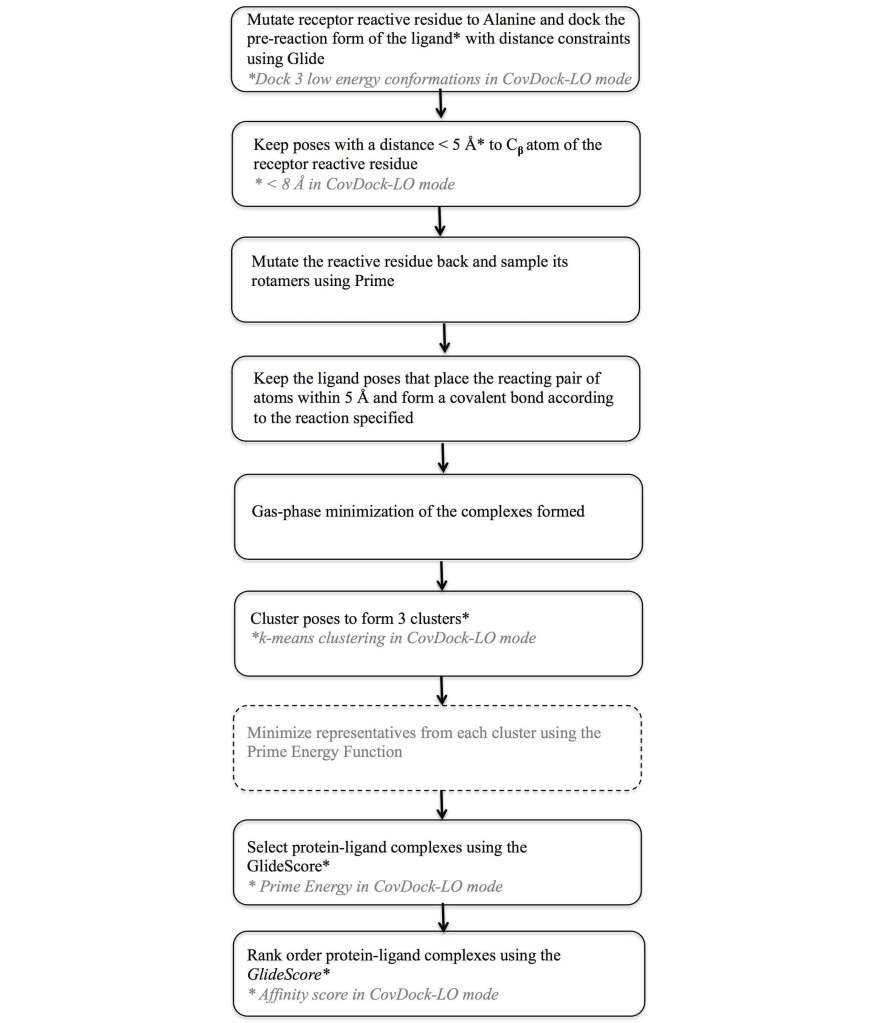
为满足这一需求,开发了一种基于共价相互作用的分子对接 协议——CovDock13、14,该协议在结合模式预测方面具有较高的准确性,并能利用SMARTS 模式自动检测反应性原子。通过结合Glide 分子对接 和Prime优化 的工作流程,CovDock-VS(虚拟筛选 )和CovDock-LO(先导化合物 优化 )模式分别支持在大规模虚拟筛选 或先导化合物 优化 项目中应用共价分子对接 。 这两种方法的工作流程如图7所示。主要得益于采样量的减少,CovDock-VS模式的运行速度比CovDock-LO模式快10到40倍。
分子对接 在一次回顾性天然分子对接 实验中,CovDock的准确性表现良好,其中CovDock-VS的平均RMSD为1.9Å,CovDock-LO为1.5Å,结果如表4所示。结合相互作用过滤器(在此情况下为氢键约束),CovDock-VS在回顾性实验中也展现出了出色的富集能力,如表5所示。 在最近的一项测试中,结果表明,在距离诱饵库5%范围内的范围内,CovDock-VS分别检出了71%、72%和77%的已知活性物质,对应的靶标分别为猫星素K、HCV NS3蛋白酶和EGFR。 即使在无法使用相互作用过滤器的情况下(如 XPO1),CovDock-VS 仍然能够在前 30% 的诱饵化合物中检索到 95% 的已知活性物质,其中 33% 的已知化合物位于前 1% 的诱饵中。
| CovDock-VS | CovDock-LO | ||
|---|---|---|---|
| 猫肽酶K的活化剂 | |||
| 1YT7-配体c | 2.68 | 0.68 | |
| 2BDL-配体 | 2.48 | 2.89a | |
| 1TU6-配体 | 1.43 | 3.18 | |
| HCV NS3蛋白酶活性物质 | |||
| 3KNX-配体 | 2.89a | 2.45 | |
| 2GVF-配体 | 1.66 | 1.51 | |
| 3LON-配体 | 6.69a | 1.81 | |
| 2OC7-配体 | 1.38 | 1.12 | |
| 2F9U-配体# | 1.19 | 1.30 | |
| 2OBO-配体 | 1.29 | 0.98 | |
| 2OC8-配体 | 1.55 | 1.04 | |
| 2A4Q-配体 | 2.51 | 2.28 | |
| 2OC0-配体 | 3.03 | 0.88 | |
| 3LOX配体 | 2.07 | 1.72 | |
| 2OC1-配体 | 3.75a | 3.14 | |
| EGFR活性物质 | |||
| 4I24-配体(达科替尼) | 1.46 | 0.85 | |
| 4G5J-配体(阿法替尼) | 1.81 | 0.86 | |
| 3IKA配体(WZ4002) | 2.53a | 1.67 | |
| 2JIV-配体(奈拉替尼) | 6.54a | 2.41a | |
| 2J5F-配体 (34-JAB) | 1.57 | 1.20 | |
| XPO1 活性物质 | |||
| 4GMX-配体 (KPT-185)c | 2.19b | 0.67 | |
| KPT-276(未提交至PDB)c | 2.54a | 1.07 | |
| 均值 | 1.87 | 1.50 | |
| EF1% | EF10% | BEDROC(α = 20) | |
|---|---|---|---|
| HCV NS3 蛋白酶 | 52 | 7 | 0.70 |
| 猫肽酶K | 9 | 8 | 0.48 |
| EGFR | 46 | 8 | 0.65 |
| XPO1 | 33 | 7 | 0.52 |
参考文献
-
Friesner, R. A.;Banks, J. L.;Murphy, R. B.;Halgren, T. A.;Klicic, J. J.; Mainz, D. T.; Repasky, M. P.; Knoll, E. H.; Shelley, M.; Perry, J. K.; Shaw, D. E.; Francis, P.; Shenkin, P. S.,“Glide :一种用于快速、准确分子对接 和评分的新方法。1. 方法及分子对接 准确性的评估”,
《医学化学杂志》,第47卷,第1739-49页(2004年)。
-
Halgren, T. A.; Murphy, R. B.; Friesner, R. A.; Beard, H. S.; Frye, L. L.; Pollard, W. T.; Banks, J. L.,“Glide :一种用于快速、准确分子对接 和评分的新方法。2. 数据库中的富集因子筛选”,
《医学化学杂志》,第47卷,第1750-59页(2004年)。
-
Friesner, R. A.; Murphy, R. B.; Repasky, M. P.; Frye, L. L.; Greenwood, J. R.; Halgren, T. A.; Sanschagrin, P. C.; Mainz, D. T.,“超精密Glide:分子对接 及评分方法,其中整合了蛋白质-配体复合物的疏水包围模型”,
《医学化学杂志》,第49卷,第6177-96页(2006年)。
-
Harder, E.; Damm, W.; Maple, J.; Wu, C.; Reboul, M.; Xiang, J. Y.; Wang, L.; Lupyan, D.; Dahlgren, M. K.; Knight, J. L.; 考斯,J. W.;切鲁蒂,D. S.;克里洛夫,G.;约根森,W. L.;阿贝尔,R.;弗里斯纳,R. A.,“OPLS3:一种广泛覆盖类药物小分子和蛋白质的力场”,
《化学理论与计算杂志》,12(1),281-296 (2016)。
-
Hartshorn, M. J.;Verkonk, M. L.;Chessari, G.;Brewerton, S. C.;Mooij, W. T. M.;Mortenson, P. N.;Murray, C. W.,“用于验证蛋白质-配体分子对接 性能的多样化、高质量测试集”,
《医学化学杂志》,第50卷,第726-741页(2007年)。
-
Huang, N.; Shoichet, B. K.; Irwin, J. J.,“分子分子对接的基准测试集”,
《医学化学杂志》,第49卷,第6789-6801页(2006年)。
-
Repasky, M. P.; Murphy, R. B.; Banks, J. L.; Greenwood, J. R.; Tubert-Brohman, I.; Bhat, S.; Friesner, R. A.,“基于Astex和DUD数据集对Glide 程序的分子对接 性能评估:Glide SP结果的完整数据集,以及整合WaterMap和Glide的新评分函数的选定结果”,
《计算机辅助分子设计杂志》,第26卷,第787-99页(2012年)。
-
Mysinger, M. M.; Carchia, M.; Irwin, J. J.; Shoichet, B. K., 《实用诱饵目录(增强版)(DUD-E):更优质的配体和诱饵,以实现更佳的基准测试》
《医学化学杂志》,第55卷,第6582-94页(2012年)。
-
库恩,B.;古巴,W.;赫特,J.;班纳,D.;比桑茨,C.;切卡雷利,S.;哈普,W.;科尔纳,M.;库格尔施塔特,A.;勒纳,C.;马泰伊,P.;内德哈特,W.;皮纳尔,E.;鲁道夫,M. G.; 舒尔茨-加施,T.;沃尔特林,T.;施塔尔,M.,《从实际应用角度看分子设计》
《医学化学杂志》,9(9),4087–4102 (2016)。
-
Tubert-Brohman, I.; Sherman, W.; Repasky, M.; Beuming, T.,“利用Glide对多肽进行改进的分子对接 ”,
《化学信息与建模杂志》,第53卷,第1689-99页(2013年)。
-
Feher, M.; Williams, C. I.,《分子对接 模拟中的数值误差与混沌行为》,
《化学信息与建模杂志》,52(3),724–738 (2012)。
-
罗伯逊(Robertson, J. G.),《酶靶向药物的作用机制》,
《生物化学》,第44卷,第5561-71页(2015年)。
-
Toledo Warshaviak, D.;Golan, G.;Borrelli, K. W.;Zhu, K.;Kalid, O.,“基于结构的虚拟筛选 方法用于发现共价结合配体”,
《化学信息与建模杂志》,第54卷,第1941-50页(2014年)。
-
Toledo Warshaviak, D.;Golan, G.;Borrelli, K. W.;Zhu, K.;Kalid, O.,“分子对接 共价抑制剂:一种无需参数的构象预测与评分方法”,
《化学信息与建模杂志》,第54卷,第1932-40页(2014年)。