借助现代化的虚拟筛选 工作流程,显著提高苗头化合物 的处理效率
Schrödinger治疗学研究组的科学家们利用了由超大规模分子对接 和绝对结合自由能计算支持的现代化虚拟筛选 工作流程,针对多种蛋白质靶点实现了两位数的苗头化合物 率。


执行摘要
- Schrödinger 开发了一套适用于小分子配体和片段的现代化虚拟筛选 工作流程,这使得Schrödinger的治疗药物研发团队在苗头化合物 药物发现工作中屡屡取得前所未有的成功
- 现代虚拟筛选 工作流程通过机器学习(ML) 增强的分子对接 以及绝对结合自由能计算技术,能够以无与伦比的准确性,高效筛选规模高达数十亿种可购化合物的超大规模化合物库。
- 该工作流程已成功应用于筛选 多个项目中的广泛目标,涵盖了完整的配体和片段
- Schrödinger……的治疗学研究组利用该工作流程,筛选出了多种经实验证实的、具有不同化学类型的先导化合物,同时大幅减少了在实验室中合成或购入并进行筛选的化合物数量——通常能实现两位数的苗头化合物 率
背景
多年来,采用传统虚拟筛选 (VS)方法进行的苗头化合物 发现工作一直面临着苗头化合物 率较低的问题,根据Schrödinger的经验,该比率通常仅为1%-2%,这意味着必须合成并检测100种化合物,才能发现1-2个有效化合物。这些挑战主要归因于两个关键因素:
首先,传统的虚拟筛选(VS)项目一直局限于规模在数十万至数百万的化合物库,对化学空间 的覆盖范围有限。这一点对于难以开发药物的靶点尤为关键,因为此类靶点在化合物库中的随机苗头化合物 率预计较低,因此规模较小的化合物库预计能筛选出的有效化合物也较少。 近年来,Enamine REAL等超大规模商业化学库的出现,以及证明筛选 大型化合物库价值的研究,进一步推动了对能够高效筛选超大规模化学空间 的技术的需求。1
其次,传统的VS方法一直受到用于对不同配体进行排序的评分方法(如GlideScore)不准确性的限制。由于这些经验评分函数仅基于复合物的静态几何结构,且对脱溶剂化效应仅作近似处理,因此从理论上讲,它们并不适合通过亲和力 对化合物进行定量排序。因此,尽管分子对接 是早期筛选中的一项强大技术,但配体的分子对接 评分通常不会与测得的活性呈相关性,且预期也不会呈现相关性。
由于这些局限性,采用传统方法进行虚拟筛选所投入的大部分资源往往被白白浪费。为了提高虚拟筛选的成功率,并确保其成为苗头化合物 药物发现的可行途径,亟需一种更具成本效益且高效的方案,以准确筛选超大规模化合物库。
设计方法
多年来,Schrödinger的药物研发团队甄选了多个具有挑战性的靶点,旨在发现高效的小分子化合物(苗头化合物 )。该团队采用了现代化虚拟筛选(VS)工作流程,借助机器学习(ML) 指导的Glide 分子对接 以及高精度的绝对结合能(Absolute BindingFEP+ ,ABFEP+)计算,对超大规模化学库进行筛选和重新评分,从而在最大限度降低实验成本和时间的同时,增加可用于从化合物筛选(苗头化合物 )向化合物筛选(先导化合物 )推进的候选化合物的数量和质量(图1)。
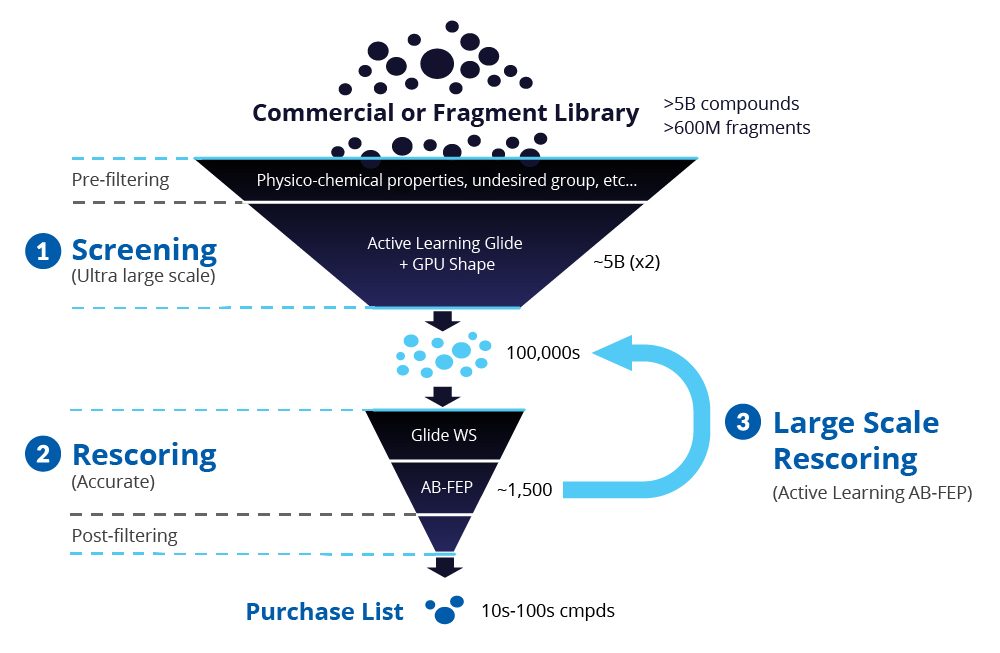
图1:Schrödinger公司现代虚拟筛选 工作流概览。
步骤 1:用于小分子库的超大规模筛选
研究团队以包含数十亿种化合物的化合物库(或最多5亿个片段的片段库)为起点,基于理化性质 进行了预过滤,以剔除任何不需要的官能团。随后,他们利用主动学习Glide (AL-Glide )进行了高通量虚拟筛选,以快速识别最具潜力的化合物。主动学习是一种有效的监督学习策略,它基于明确定义的目标,为下一轮训练优先选择训练数据。 AL-Glide 将机器学习(机器学习(ML) , ML)与主动学习(分子对接 )相结合,从而能够将基于生物活性富集(分子对接 )的方法应用于数十亿个化合物的化合物库。2通过采用这种方法,仅对化合物库中的一小部分进行对接计算,从而将计算成本显著降低至更合理的水平。
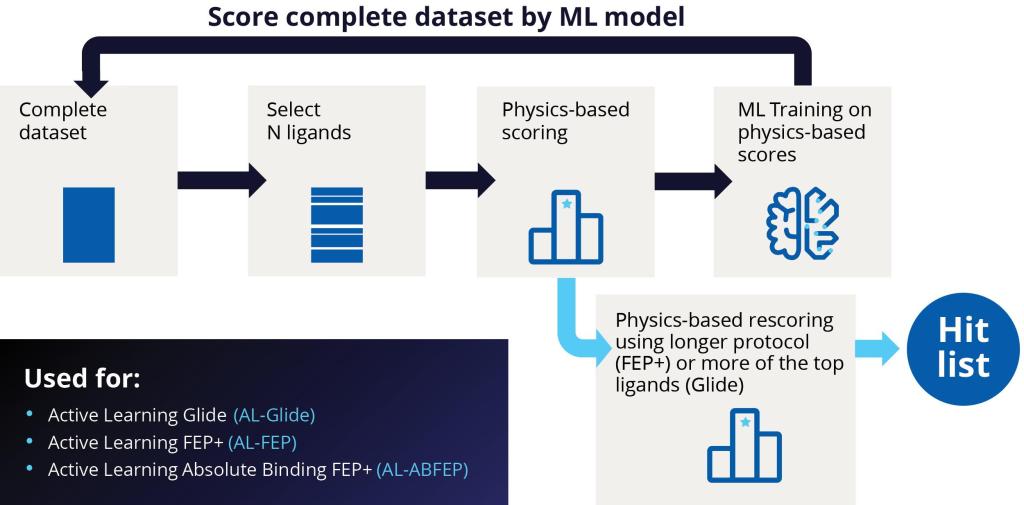
在主动学习周期的开始阶段,会从化合物库的完整数据集中选取一批可处理的化合物进行对接。随后,将这些选定的化合物加入训练集。接着,利用新信息对模型进行训练,并随着机器学习(ML) 模型对分子对接 方法的拟合精度不断提升,该过程将持续迭代(图2)。
与暴力搜索法分子对接 相比,这种基于机器学习的分子对接 模型能够更快地评估化合物。虽然使用Glide 进行典型的分子对接 计算时,每个化合物平均可能需要几秒钟,但机器学习模型能够以显著更快的速度进行评估或预测,从而大幅提高通量。因此,该机器学习生成的模型被用于评估整个化合物库。
在完成AL-Glide 筛选后,研究团队使用Glide 对得分最高的化合物进行了完整的分子对接 计算,通常涉及1000万至1亿个化合物。
步骤 2:重新评分
随后,根据Glide 分子对接 评分结果,筛选出最具潜力的化合物,并使用Glide WS进行重新评分。 WS是一款先进的分子对接 程序,它利用结合位点 中的显式水信息,相较于仅使用Glide ,能更有效地富集活性化合物,这在很大程度上得益于其改进的构象预测能力。Glide WS有助于筛选出更优质的化合物以供后续的ABFEP+评分步骤使用,并提供更可靠的结合构象,从而减少该过程中的假阳性结果。3
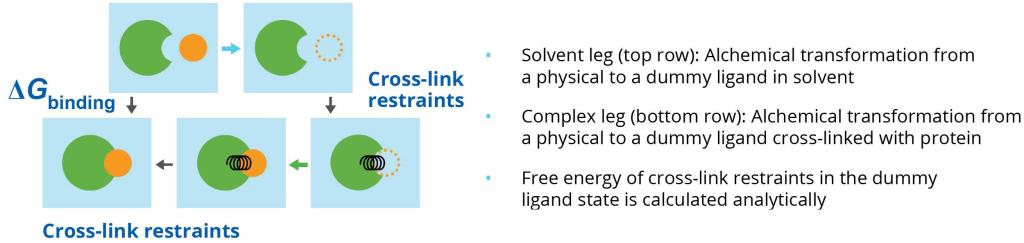
从分子对接 中筛选出富集分数最高的化合物,并使用ABFEP+进行严格的重新评分。ABFEP+是Schrödinger公司FEP+ 技术中的一种协议,可精确计算配体/蛋白质复合物结合态与未结合态之间的结合自由能(图3)。4,5事实证明,ABFEP+与实验测得的结合亲和力之间存在可靠的相关性。 与相对结合FEP+ 不同,ABFEP+无需以类似的、经实验测定的参考化合物作为起点。由于ABFEP+能够评估并准确评分多种化学类型,因此它是虚拟筛选项目中发现最具活性的化合物的关键技术。
步骤 3:大规模重新评分
与相对结合FEP+ (RB-FEP+ )相比,ABFEP+的计算成本较高,每个配体需要多块GPU,且计算时间约为后者的4倍。在苗头化合物 的药物发现项目中,通常仅能实际运行数千次ABFEP+计算。为了充分发挥ABFEP+的真正富集优势,采用了主动学习方法对数量更为庞大的化合物进行评分。
* 分子量在100至250 Da之间的化合物
将现代虚拟筛选 工作流应用于碎片
实验性片段筛选 已催生出多种经FDA 批准的药物和临床候选药物。通过将这一现代工作流程应用于片段筛选 ,Schrödinger的治疗学小组已成功将筛选 的筛选规模扩大至数百万个片段,而传统高通量筛选(HTS)技术仅能筛选 3k 至 30k 个片段。
该计算机模拟方法解决了实验性片段筛选 的一个根本性局限——片段必须具有足够的溶解度,才能在高浓度(100 μM 至 mM)下针对各种靶点进行检测。然而,在计算机模拟中严格估算效力并不受溶解度的限制,因此,如果根据估算的效力预测片段具有足够的溶解度,就可以对其效力进行评估,并在此基础上进一步开展研究。 针对特定靶点(靶点 )的结合效力是通过主动学习算法ABFEP+计算得出的。最终,优先片段会在预测效力下,通过Solubility(FEP+ )进行体外溶解度评估。⁶本质上,该方法通过颠倒效力与溶解度的问题来实现规模化,从而能够发现实验片段库中本不存在的、高效力且配体效率高的片段。
迄今为止,该团队已针对多个具有挑战性的靶点完成了共计九项基于大片段*的虚拟筛选,其中包括一项基于同源模型的筛选。这九项筛选均获得了多个高效强效配体候选物,其效力范围从低nM到30 μM不等,且苗头化合物 率均达到两位数。
Schrödinger的现代化VS工作流对多个项目和目标中苗头化合物 发生率的影响
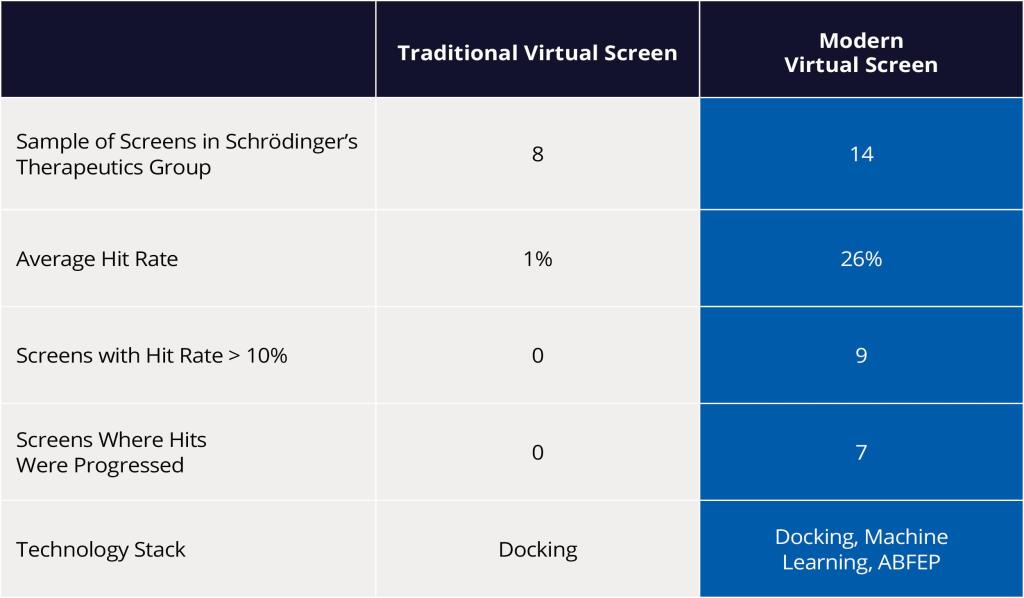
借助这些现代虚拟筛选(VS)方法,Schrödinger 的科学家们成功证明,与传统筛选方法相比,虚拟筛选(苗头化合物 )的成功率有了显著提升。因此,他们成功鉴定出多种具有高预测结合亲和力 的苗头化合物 化合物,并对其进行了获取、实验测试和验证,最终确认这些化合物为有效候选物——从而实现了令人印象深刻的两位数百分比苗头化合物 率(图4)。
结论
长期以来,基于计算的苗头化合物 鉴定一直依赖于规模较小的文库和准确率较低的方法来筛选化学空间 ,这导致苗头化合物 率较低,且在很大程度上浪费了实验资源。
通过转向一种利用严格的基于物理理论 方法的现代化工作流程——包括结合绝对结合FEP+ 与机器学习(ML) ——Schrödinger的治疗学团队已成功将该工作流程应用于多个项目中的各类靶点,并实现了可重复的两位数苗头化合物 率。在此过程中,该团队大幅减少了为筛选出项目先导化合物 候选药物而需合成和测试的化合物数量,从而降低了总体成本并缩短了项目周期。
该策略通过使药物发现团队能够探索快速增长的超大规模化学库,从而增强其研发能力。它能够高效地穿梭于化学空间 这一庞大迷宫之中,显著提高发现具有更优性质的多个先导化合物(hits)以及选择性 的概率。此外,它还能加速药物开发进程,从而更快地发现更高质量的新型药物候选物。
参考文献
-
用于发现新化学类型的超大规模化合物库分子对接 。Lyu J 等。
《自然》杂志。2019年2月;566(7743):224–229。
-
利用分子对接 和深度学习对化学空间 进行高效探索。杨Y等。
《化学理论与计算》2021年,第17卷,第11期,第7106–7119页。
-
WScore:一种处理配体-受体分子对接 中显式水分子时既灵活又精确的方法。
Murphy RB 等。《医学化学杂志》2016 年,第 59 卷,第 4364−4384 页。
-
通过精确计算蛋白-配体结合的绝对自由能,提升虚拟筛选 中的苗头化合物 发现效率。
陈W等。《化学信息与建模杂志》2023年,第63卷,第10期,第3171–3185页。
-
准确计算药物分子的结合绝对自由能。
Aldeghi M 等。《Chem. Sci.》2016;7:207–218。
-
一种利用三维分子构象和堆积来评估水溶液热力学溶解度的创新基于物理理论 集合建模方法:以口服型溴结构域和非末端结构域抑制剂先导化合物 为例优化 系列。
Hong RS 等。《化学信息与建模杂志》2021 年,第 61 卷,第 3 期,第 1412–1426 页。