DeepAutoQSAR 硬件基准测试


执行摘要
- 该基准测试利用不同的硬件配置和模型训练时间,评估了DeepAutoQSAR在两个不同规模的数据集上的性能。
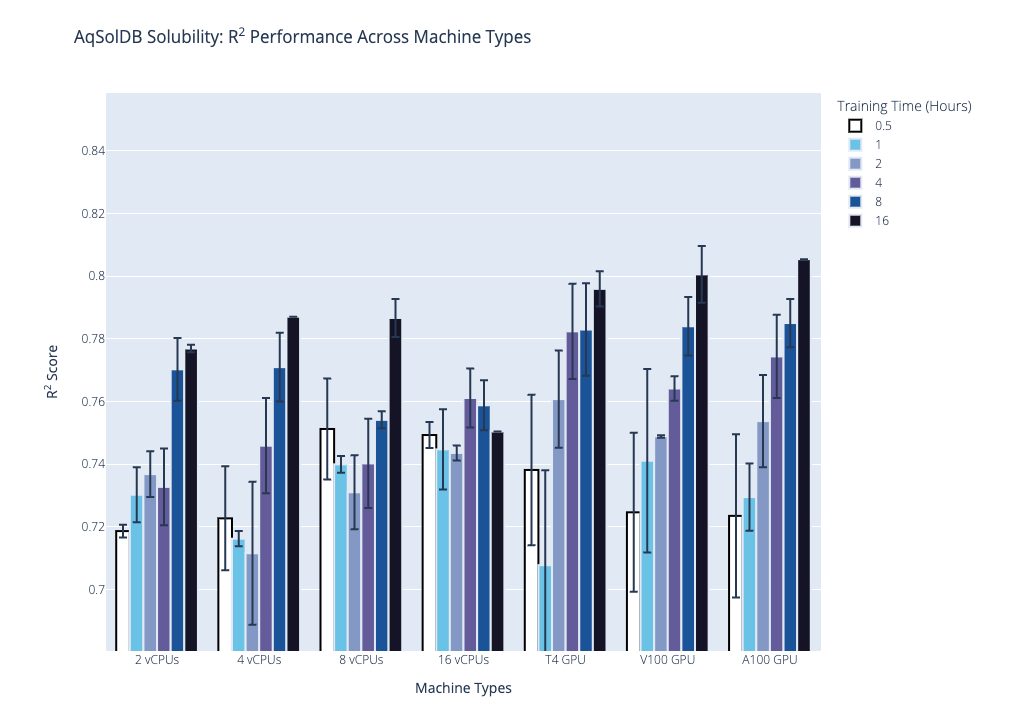
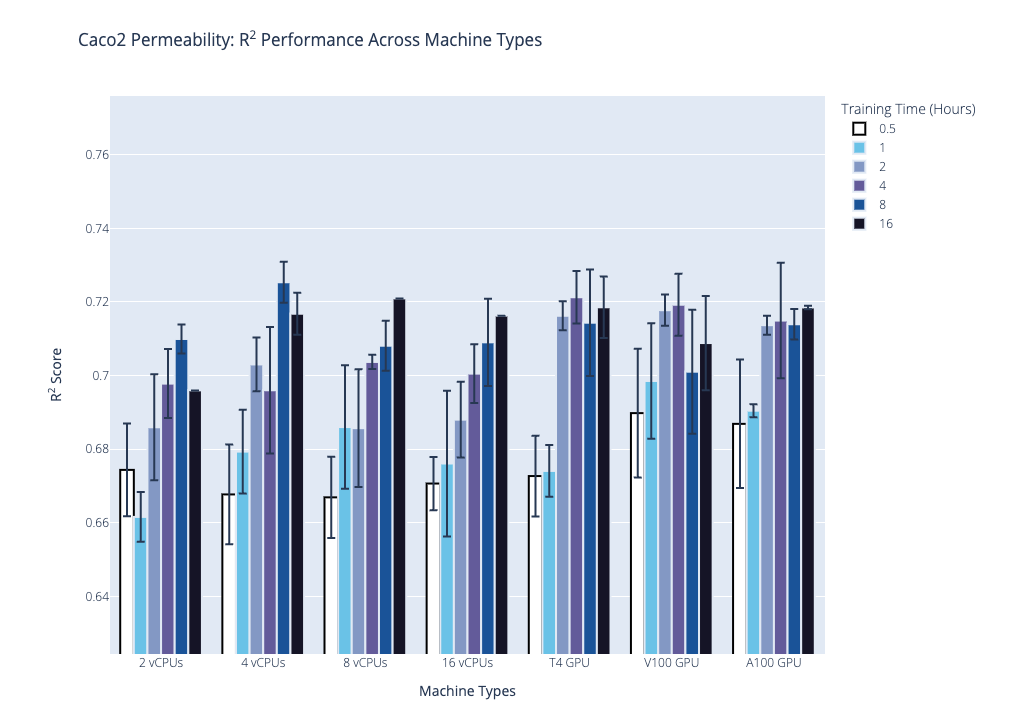
- 根据测试结果和硬件成本,我们的一般建议是使用 NVIDIA T4 GPU 硬件,具体训练时间如下:数据点少于 1,000 个的数据集需 2 小时;1,000 至 10,000 个数据点的数据集需 4 小时;超过 10,000 个数据点的数据集需 8 小时。
- 虽然性能最终取决于数据,但本基准测试的初衷是作为选择用于训练机器学习模型的硬件以及确定具体模型训练时间的参考依据。实际性能在很大程度上取决于具体的数据集,可能需要延长训练时间或选择其他GPU才能达到预期效果。
引言
将机器学习(机器学习(ML) ,ML)应用于预测候选药物的分子特性,是一项重要的研究领域,有望缩短药物研发周期,并加速为存在严重未满足医疗需求的患者开发新药。
机器学习能否成功应用,取决于数据数量和质量是否充足、针对特定问题的模型架构是否合适、超参数(特定机器学习模型架构的参数)的选择是否恰当,以及针对所选硬件配置的模型训练时间是否合理。
DeepAutoQSAR是机器学习(ML) 的一款产品,可帮助用户根据化学结构预测分子性质。其自动化的有监督学习流程使新手和经验丰富的用户都能创建并部署业界领先的定量结构活性/性质关系(QSAR/QSPR)模型。
本基准测试基于此前一份白皮书[1]的研究成果,旨在评估DeepAutoQSAR在两个不同规模的数据集上,采用不同硬件配置和模型训练时长时的性能表现。虽然性能最终取决于数据,但本基准测试的初衷是作为选择用于训练机器学习模型的硬件以及确定具体模型训练时长的起点。
数据集
基准测试中使用的数据集来自治疗数据共享平台(TDC)。TDC 提供可直接用于机器学习的数据集,这些数据集可用于对制药研发具有重要价值的机器学习任务,并涵盖不同的治疗方式和药物研发生命周期的各个阶段 [2]。
我们使用了两个数据集,每个数据集都包含一项吸收、分布、代谢和排泄(ADME)特性的检测数据:
- Caco2(人上皮细胞有效通透性)
- AqSolDB(水溶性)
性能通过训练集-测试集数据划分样本中ADME属性预测的准确率中位数来衡量;请注意,所使用的具体训练集-测试集数据划分与TDC为其基准排行榜提供的划分不同。
数据集描述
Caco2(人上皮细胞有效通透性)[3]*
人类结肠上皮癌细胞系Caco-2被用作模拟人体肠道组织的体外模型。关于药物通过Caco-2细胞速率的实验结果,可近似反映药物渗透通过人体肠道组织的速率。
该数据集包含用于回归分析的数值数据,共包含906种化合物。
AqSolDB(水溶性)[4]*
水溶性衡量的是药物在水中溶解的能力。水溶性差可能先导化合物 导致药物吸收缓慢、生物利用度不足,甚至引发毒性。超过40%的新化学实体不具有水溶性。
该数据集包含用于回归分析的数值型(非整数)数据,共包含9845种化合物。
*注:数据集已从原始形式进行修改,以消除结构冗余和实验误差。
硬件
基准测试中使用的硬件是从 Google 云平台 (GCP) 调配的;因此,所选的硬件配置是基于 Google 提供的机器类型确定的。
这些由云服务提供商规定的硬件配置限制意味着,仅提供特定的硬件组合,例如某款GPU平台只能与特定的CPU平台配合使用。 例如,NVIDIA A100 GPU 只能在 A2 机器类型上运行,而该机器类型仅使用英特尔 Cascade Lake CPU 平台。受这些限制的制约,我们竭尽全力确保不同机器类型间的硬件特定选项保持一致,在合理范围内提供硬件多样性,并采用性价比高的高性能计算硬件。
| 硬件密钥 | GCP 机器类型 | CPU 平台 | vCPU* | 内存(GB) | GPU 平台 | GPU | 每小时费用($)+ |
|---|---|---|---|---|---|---|---|
| 2 个 vCPU | n2-standard-2 | 英特尔 Ice Lake | 2 | 8 | 不适用 | 无 | $0.10 |
| 4 个 vCPU | n2-标准-4 | 4 | 16 | $0.19 | |||
| 8 个 vCPU | n2-standard-8 | 8 | 32 | $0.39 | |||
| 16 个 vCPU | n2-standard-16 | 16 | 64 | $0.78 | |||
| T4 GPU | n1-标准-4 | 英特尔 Ice Lake** | 4 | 15 | 英伟达 T4 | 1 | $0.54 |
| V100 GPU | 英伟达 V100 | $2.67 | |||||
| A100 GPU | a2-highgpu-1g | 英特尔 Cascade Lake | 12 | 85 | 英伟达 A100 | $3.67 |
** 最高支持英特尔 Ice Lake 代;GCP 会在创建节点池时自动分配 CPU 平台。
+ 2022 年 11 月的价格。包含持续使用折扣。
基准测试方法与结果
我们的基准测试是一个两阶段的过程。在第一阶段,通过标准交叉验证流程对 DeepAutoQSAR 模型进行训练,使其适应 TDC 数据集,从而为模型集合筛选出表现最佳的机器学习模型并优化超参数;该阶段的最终结果是一组表现最佳的模型集合,在正常使用情况下,会对这些模型进行平均计算,以得出平均预测值及相应的集合标准差。 我们在白皮书《Therapeutic Data Commons ADMET子集上DeepAutoQSAR、ChemProp和DeepPurprose的基准研究》[1]中详细阐述了具体流程。在第二阶段,对数据进行随机训练-测试分割,并将先前确定的、具有特定超参数配置的顶级机器学习模型架构集合,在新的训练数据分割上进行训练。 随后针对新的测试数据分割生成预测结果。这些多分割指标通过减少单一训练-测试数据分割可能引入的偏差,提供了对模型性能更稳健的估计。本硬件基准测试中,模型性能以各硬件配置和模型训练时间下,这些随机训练-测试分割的决定系数R²中位数[5]作为报告指标。
在第一阶段,初始训练流程会在每个预设的训练时长内持续运行。由于超参数优化 和模型架构选择具有随机性,每次运行基准测试任务时,每种硬件与训练时长的组合都可能探索到不同数量的模型架构和超参数组合。评估的模型训练时长包括:0.5、1、2、4、8和16小时。 一般而言,在较小数据集上运行更长时间的性能更强的硬件(例如,配备 A100 GPU 的机器在较小的 Caco2 渗透率数据集上训练 16 小时),将探索比在较大数据集上运行较短时间的性能较弱的硬件(例如,双核机器在较大的 AqSolDB 数据集上训练 2 小时)更多的超参数组合。
由于模型架构选择和超参数采样是一个随机过程,我们对每种基准配置(即特定的硬件与训练时间组合)各运行三次,并报告性能的平均值——当探索的超参数组合较少时,这一点尤为重要,因为此时模型性能对超参数采样的敏感度更高。第一阶段的输出是通过交叉验证确定的顶级模型集合,其中每个模型都配有具体的超参数选择。
我们的基准测试第二阶段的训练时间是第一阶段的一半。随着训练时间的增加,由于性能中位数趋于一个与数据拆分方式无关的值,统计结果会更加稳健,但这会以计算成本增加为代价;在实际应用中,必须在计算成本与确保集合模型获得足够长的训练时间之间取得平衡。 在性能报告中,我们提供基于多次训练-测试划分计算出的决定系数R²中位数[5],旨在减少单一训练-测试划分可能引入的偏差。为了计算该R²值,我们通过带替换的引导采样反复将数据划分为训练集和测试集;具体而言,从包含N个数据点的数据集中带替换地抽取N个样本,并去除重复项以形成子集。 随后,将选中的数据点用于训练第一阶段确定的特定模型架构,未选中的数据点则作为测试保留集。我们重复此过程直至达到时间限制,并报告所有重采样结果的R²中位数。
由于两个 TDC 数据集均为数值回归问题,因此该指标是衡量模型性能的合理标准;但在实际应用中,性能指标的选择应始终根据集成模型的具体应用场景来确定。有时,均方误差(MAE)或均方根误差(RMSE)更适合用于评估模型的性能是否足够好。第二阶段的输出是集成模型在不同训练-测试划分下的性能分布;所报告的数值即为该分布的中位数。
下图展示了基准测试结果,即第二阶段的R²决定系数中位数。 第一幅图展示了在 AqSolDB 数据集上的性能表现,第二幅图则展示了在 Caco2 渗透率数据集上的性能表现。针对这两个数据集,我们按硬件类型分组,突出了性能随时间的变化趋势:其中,x 轴表示硬件类型,柱状图的颜色代表训练时长(单位:小时),y 轴表示R²系数的中位数。用于生成这些图表的数据详见补充表格。
基于这些结果和硬件成本,我们提出以下总体建议:
| 数据点数量 | 硬件 | 培训时间(小时) |
|---|---|---|
| <1,000 | 英伟达 T4 GPU | 2 |
| 1,000 – 10,000 | 4 | |
| >10,000 | 8 |
部分出版物
-
Kaplan, Z.; Ehrlich, S.; Leswing, K. 《DeepAutoQSAR、ChemProp 和 DeepPurpose 在 Therapeutic Data Commons ADMET 子集上的基准研究》。Schrödinger, Inc., 2022.
https://www.schrodinger.com/science-articles/benchmark-study-deepautoqsar-chemprop-and-deeppurpose-admet-subset-therapeutic-data (accessed 2022-11-29).
-
治疗数据共享平台。
https://tdcommons.ai/ (accessed 2022-06-15).
-
ADME – TDC。
https://tdcommons.ai/single_pred_tasks/adme/#caco-2-cell-effective-permeability-wang-et-al (accessed 2022-06-15).
-
ADME – TDC。
https://tdcommons.ai/single_pred_tasks/adme/#solubility-aqsoldb (accessed 2022-06-15).
-
Sklearn.metrics.r2_score — scikit-learn 1.1.3 文档。
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.r2_score.html#sklearn-metrics-r2-score (accessed 2022-11-29).