DeepAutoQSAR ハードウェアベンチマーク


要約
- このベンチマークでは、異なるハードウェア構成およびモデル学習時間を用いて、規模の異なる2つのデータセットにおけるDeepAutoQSARの性能を評価しています。
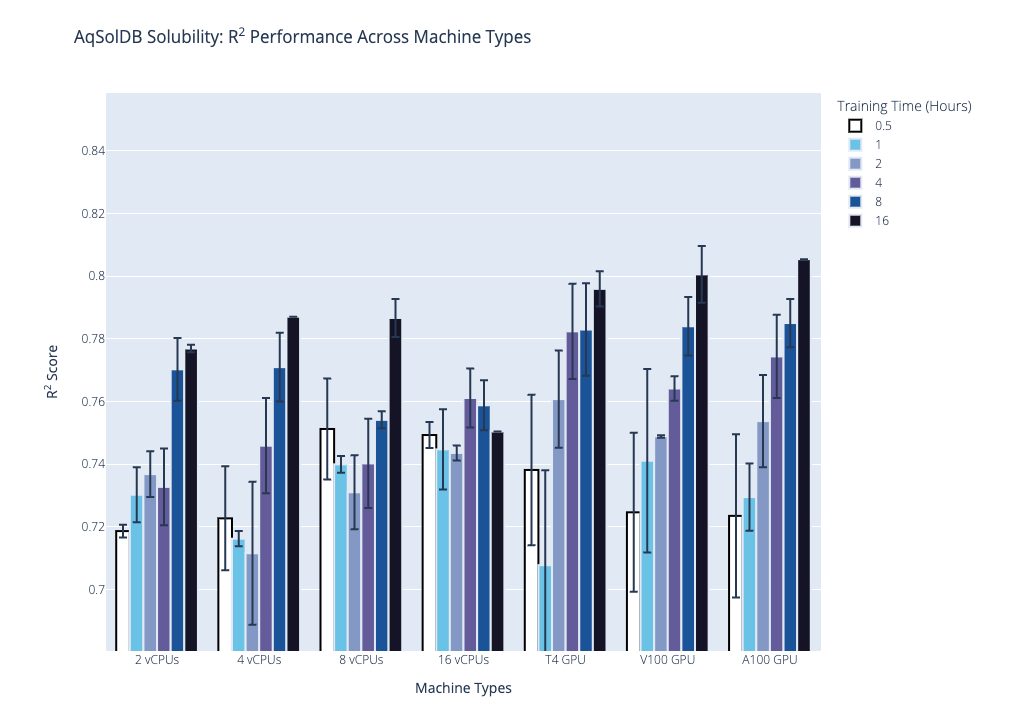
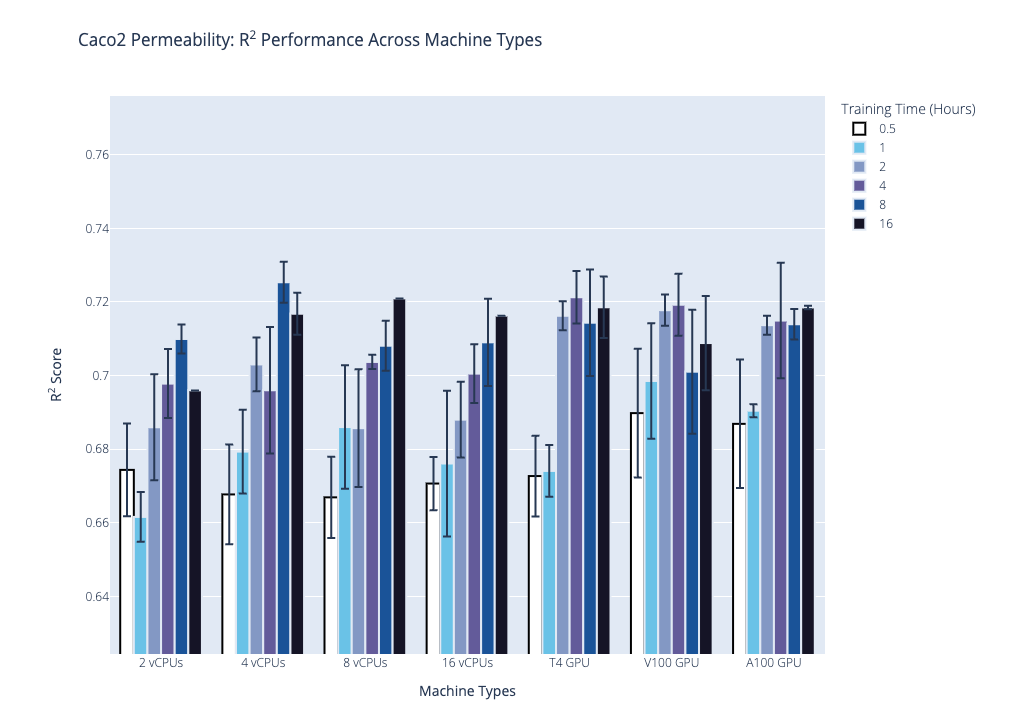
- 結果とハードウェアコストを踏まえた当社の一般的な推奨事項としては、NVIDIA T4 GPUハードウェアを使用し、データポイントが1,000未満のデータセットでは2時間、1,000~10,000のデータセットでは4時間、10,000を超えるデータセットでは8時間のトレーニング時間を設定することをお勧めします。
- パフォーマンスは最終的にはデータに依存しますが、このベンチマークの目的は、MLモデルの学習に使用するハードウェアや具体的な学習時間を決定するための参考情報を提供することにあります。実際のパフォーマンスは特定のデータセットに大きく左右されるため、望ましい結果を得るには、学習時間を延長したり、別のGPUを選択したりする必要がある場合があります。
はじめに
創薬候補化合物の分子的特性を予測するための機械学習(ML)の応用は、創薬の期間を短縮し、深刻なアンメット・メディカル・ニーズを抱える患者のための医薬品の開発を加速させる可能性を秘めた、重要な研究分野である。
機械学習を成功させるには、十分なデータ量と品質、与えられた問題に適したモデルアーキテクチャ、適切なハイパーパラメータの選択(特定の機械学習モデルアーキテクチャのパラメータ)、および選択したハードウェア構成に適したモデル学習時間が不可欠である。
DeepAutoQSARは、化学構造 に基づいて分子特性を予測できる機械学習製品です。この自動化された教師あり学習パイプラインにより、初心者から経験豊富なユーザーまで、最高水準の定量的構造 活性・特性相関(QSAR/QSPR)モデルを作成・導入することが可能になります。
以前のホワイトペーパー[1]の成果を基に作成された本ベンチマークの目的は、異なるハードウェア構成およびモデル学習時間を用いて、規模の異なる2つのデータセットにおけるDeepAutoQSARの性能を評価することである。性能は最終的にはデータに依存するが、本ベンチマークの主たる目的は、機械学習モデルの学習に使用するハードウェアや具体的なモデル学習時間を選択するための出発点となることにある。
データセット
ベンチマークで使用されたデータセットは、Therapeutics Data Commons(TDC)から入手したものである。TDCは、製薬の研究開発において有用な学習タスクに利用可能な、機械学習対応のデータセットを提供しており、これらはさまざまな治療領域や医薬品開発ライフサイクルの各段階を網羅している[2]。
我々は、それぞれ1つの吸収・分布・代謝・排泄(ADME)特性に関するアッセイデータを含む2つのデータセットを使用しています:
- Caco2(ヒト上皮細胞の有効透過性)
- AqSolDB(水溶性)
性能は、トレーニングデータとテストデータに分割されたサンプルに対するADME特性予測の精度の中央値によって測定されます。なお、ここで使用されている具体的なトレーニングデータとテストデータの分割方法は、TDCがベンチマークのリーダーボードで提供している分割方法とは異なります。
データセットの説明
Caco2(ヒト上皮細胞の有効透過性)[3]*
ヒト結腸上皮がん細胞株であるCaco-2は、ヒト腸組織を模擬するためのin vitroモデルとして用いられている。Caco-2細胞を通過する薬剤の透過率に関する実験結果は、薬剤がヒト腸組織を透過する速度を概算する指標となる。
このデータセットには、回帰分析に使用する数値データが含まれており、906種類の化合物が収録されています。
AqSolDB(水溶性) [4]*
水溶性とは、薬剤が水に溶ける能力を指します。水溶性が低いと、薬剤の吸収が遅くなったり、生物学的利用能が不十分になったり、さらには毒性を引き起こす可能性もあります。新規化合物(NCE)の40%以上は水に溶けません。
このデータセットには、回帰分析に使用する数値データ(整数以外のデータ)が含まれており、9845個の化合物が収録されています。
*注:データセットは、構造上の冗長性や実験上の誤差を取り除くため、元の形式から修正されています。
ハードウェア
ベンチマークに使用したハードウェアはGoogle Cloud Platform(GCP)からプロビジョニングされたものであるため、ハードウェア構成はGoogleが提供するマシンタイプに基づいて選定された。
クラウドプロバイダーによって定められたこうしたハードウェア構成上の制約により、特定のCPUプラットフォームと組み合わせてのみ使用できる特定のGPUプラットフォームなど、利用可能なハードウェアの組み合わせは限られています。 例えば、NVIDIA A100 GPUは、Intel Cascade Lake CPUプラットフォームのみを使用する「A2」マシンタイプでのみ実行可能です。こうした制約の下、マシンタイプ間でハードウェア固有のオプションの一貫性を保ち、合理的な範囲でハードウェアの多様性を確保し、コスト効率に優れた高性能コンピューティング用ハードウェアを活用するよう、あらゆる努力が払われました。
| ハードウェアキー | GCP マシンタイプ | CPUプラットフォーム | vCPU* | RAM(GB) | GPUプラットフォーム | GPU | 1時間あたりの費用($)+ |
|---|---|---|---|---|---|---|---|
| 2 vCPU | n2-standard-2 | インテル・アイスレイク | 2 | 8 | 該当なし | なし | $0.10 |
| 4 vCPU | n2-standard-4 | 4 | 16 | $0.19 | |||
| 8 vCPU | n2-standard-8 | 8 | 32 | $0.39 | |||
| 16 vCPU | n2-standard-16 | 16 | 64 | $0.78 | |||
| T4 GPU | n1-standard-4 | Intel Ice Lake** | 4 | 15 | Nvidia T4 | 1 | $0.54 |
| V100 GPU | Nvidia V100 | $2.67 | |||||
| A100 GPU | a2-highgpu-1g | インテル・カスケード・レイク | 12 | 85 | Nvidia A100 | $3.67 |
** Intel Ice Lake 世代まで。GCP では、ノードプールの作成時に CPU プラットフォームが自動的に割り当てられます。
+ 2022年11月時点の価格です。サステインドユース割引が含まれています。
ベンチマーク手法と結果
当社のベンチマークは2段階のプロセスで構成されています。第1段階では、DeepAutoQSARモデルをTDCデータセットに合わせて学習させ、標準的な交差検証手順を用いて、モデルアンサンブルに組み込む高性能な機械学習モデルを選定するとともに、ハイパーパラメータを最適化します。この段階の最終成果物は、高性能なモデルのアンサンブルであり、通常の使用状況下では、これらを平均化して平均予測値とそれに関連するアンサンブル標準偏差を算出します。 具体的なプロトコルについては、当社のホワイトペーパー『Therapeutic Data CommonsのADMETサブセットにおけるDeepAutoQSAR、ChemProp、およびDeepPurproseのベンチマーク研究』[1]で詳述しています。第2段階では、データのランダムな訓練・テスト分割が計算され、事前に決定された、特定のハイパーパラメータ設定を持つ高性能MLモデルアーキテクチャのアンサンブルが、新しい訓練データ分割に対して学習されます。 その後、新しいテストデータ分割に対して予測が生成される。これらのマルチスプリット指標は、単一の学習・テストデータ分割から生じる潜在的なバイアスを低減することで、モデル性能のより堅牢な推定値を提供する。本ハードウェアベンチマークにおけるモデル性能は、各ハードウェア構成およびモデル学習時間について、これらのランダムな学習・テストデータ分割全体における決定係数R²の中央値[5]として報告される。
第1段階では、各トレーニング時間枠ごとに初期トレーニング手順が継続的に実行されます。ハイパーパラメータの最適化やモデルアーキテクチャの選択には確率的な性質があるため、ベンチマークジョブが実行されるたびに、ハードウェアとトレーニング時間の組み合わせごとに、探索されるモデルアーキテクチャやハイパーパラメータの組み合わせの数が異なる可能性があります。評価対象としたモデルトレーニング時間は、0.5、1、2、4、8、および16時間でした。 一般的な傾向として、小規模なデータセットに対してより高性能なハードウェアで長時間のトレーニングを実行する場合(例:A100 GPUを搭載したマシンが、小規模なCaco2透水性データセットに対して16時間トレーニングを行う場合)、大規模なデータセットに対して性能の低いハードウェアで短時間のトレーニングを実行する場合(例:2コアのマシンが、大規模なAqSolDBデータセットに対して2時間トレーニングを行う場合)よりも、より多くのハイパーパラメータの組み合わせを探索することになります。
モデルのアーキテクチャ選択とハイパーパラメータのサンプリングは確率的なプロセスであるため、特定のハードウェアと学習時間の組み合わせである各ベンチマーク構成を3回実行し、そのパフォーマンスの平均値を報告する。これは、探索されるハイパーパラメータの組み合わせが少ない場合に特に重要である。なぜなら、モデルのパフォーマンスはハイパーパラメータのサンプリングに対してより敏感に反応するからである。第1段階の出力は、交差検証によって決定された上位モデルのアンサンブルであり、各モデルには特定のハイパーパラメータが設定されている。
ベンチマークの第2段階は、第1段階の学習時間の半分で実行されます。学習時間を長くすると、パフォーマンスの中央値が分割方法に依存しない値に収束するため、統計的堅牢性が高まりますが、その代償として計算コストが増加します。実際には、計算コストと、アンサンブルモデルを十分に長い学習時間をかけて学習させる必要性とのバランスをとらなければなりません。 性能報告については、単一の訓練・テスト分割によって生じうるバイアスを低減することを目的として、複数の訓練・テスト分割から算出した決定係数R²の中央値[5]を提示する。このR²を算出するために、置換ありのブートストラップサンプリングを用いてデータを繰り返し訓練セットとテストセットに分割する。具体的には、合計N個のデータポイントからなるデータセットから、置換ありでN個のサンプルを抽出し、重複を削除して部分集合を形成する。 次に、選択されたデータポイントを用いて、第1段階で特定されたモデルアーキテクチャの学習を行い、選択されなかったデータポイントはテスト用ホールドアウトとして使用します。この処理を時間制限に達するまで繰り返し、すべての再サンプリングにおけるR²の中央値を報告します。
TDCの2つのデータセットはいずれも数値回帰問題であるため、この指標はモデルの性能を評価する上で妥当な尺度となります。ただし、実世界での応用においてどの性能指標を採用するかは、常にアンサンブルモデルのユースケースに応じて決定すべきです。モデルの性能が十分であるかどうかを評価するには、MAEやRMSEの方が適切な場合もあります。第2段階の出力は、さまざまな訓練・テスト分割におけるアンサンブルモデルの性能の分布であり、報告されている値はその分布の中央値です。
以下に、第2段階における決定係数R²の中央値であるベンチマーク結果をプロットします。 最初のグラフはAqSolDBデータセットでの性能を示し、2番目のグラフはCaco2透過性データセットでの性能を示しています。これらの各データセットについて、ハードウェアの種類ごとにグループ分けして、時間の経過に伴う性能の推移を強調して示しています。ここで、X軸はハードウェアの種類、棒グラフの色はトレーニング時間(時間単位)、Y軸はR²スコアの中央値となっています。グラフの作成に使用したデータは、補足表に記載されています。
これらの結果およびハードウェアのコストを踏まえ、当社の一般的な推奨事項は以下の通りです:
| データポイント数 | ハードウェア | 研修時間(時間) |
|---|---|---|
| <1,000 | Nvidia T4 GPU | 2 |
| 1,000 ~ 10,000 | 4 | |
| >10,000 | 8 |
主な出版物
-
Kaplan, Z.; Ehrlich, S.; Leswing, K. 「Therapeutic Data CommonsのADMETサブセットにおけるDeepAutoQSAR、ChemProp、およびDeepPurposeのベンチマーク研究」。Schrödinger, Inc., 2022.
https://www.schrodinger.com/science-articles/benchmark-study-deepautoqsar-chemprop-and-deeppurpose-admet-subset-therapeutic-data (accessed 2022-11-29).
-
治療データ・コモンズ。
https://tdcommons.ai/ (accessed 2022-06-15).
-
ADME – TDC。
https://tdcommons.ai/single_pred_tasks/adme/#caco-2-cell-effective-permeability-wang-et-al (accessed 2022-06-15).
-
ADME – TDC。
https://tdcommons.ai/single_pred_tasks/adme/#solubility-aqsoldb (accessed 2022-06-15).
-
Sklearn.metrics.r2_score — scikit-learn 1.1.3 ドキュメント。
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.r2_score.html#sklearn-metrics-r2-score (accessed 2022-11-29).