使用 ConfGen 准确、快速地生成构象
在再现生物活性配体构象方面的表现
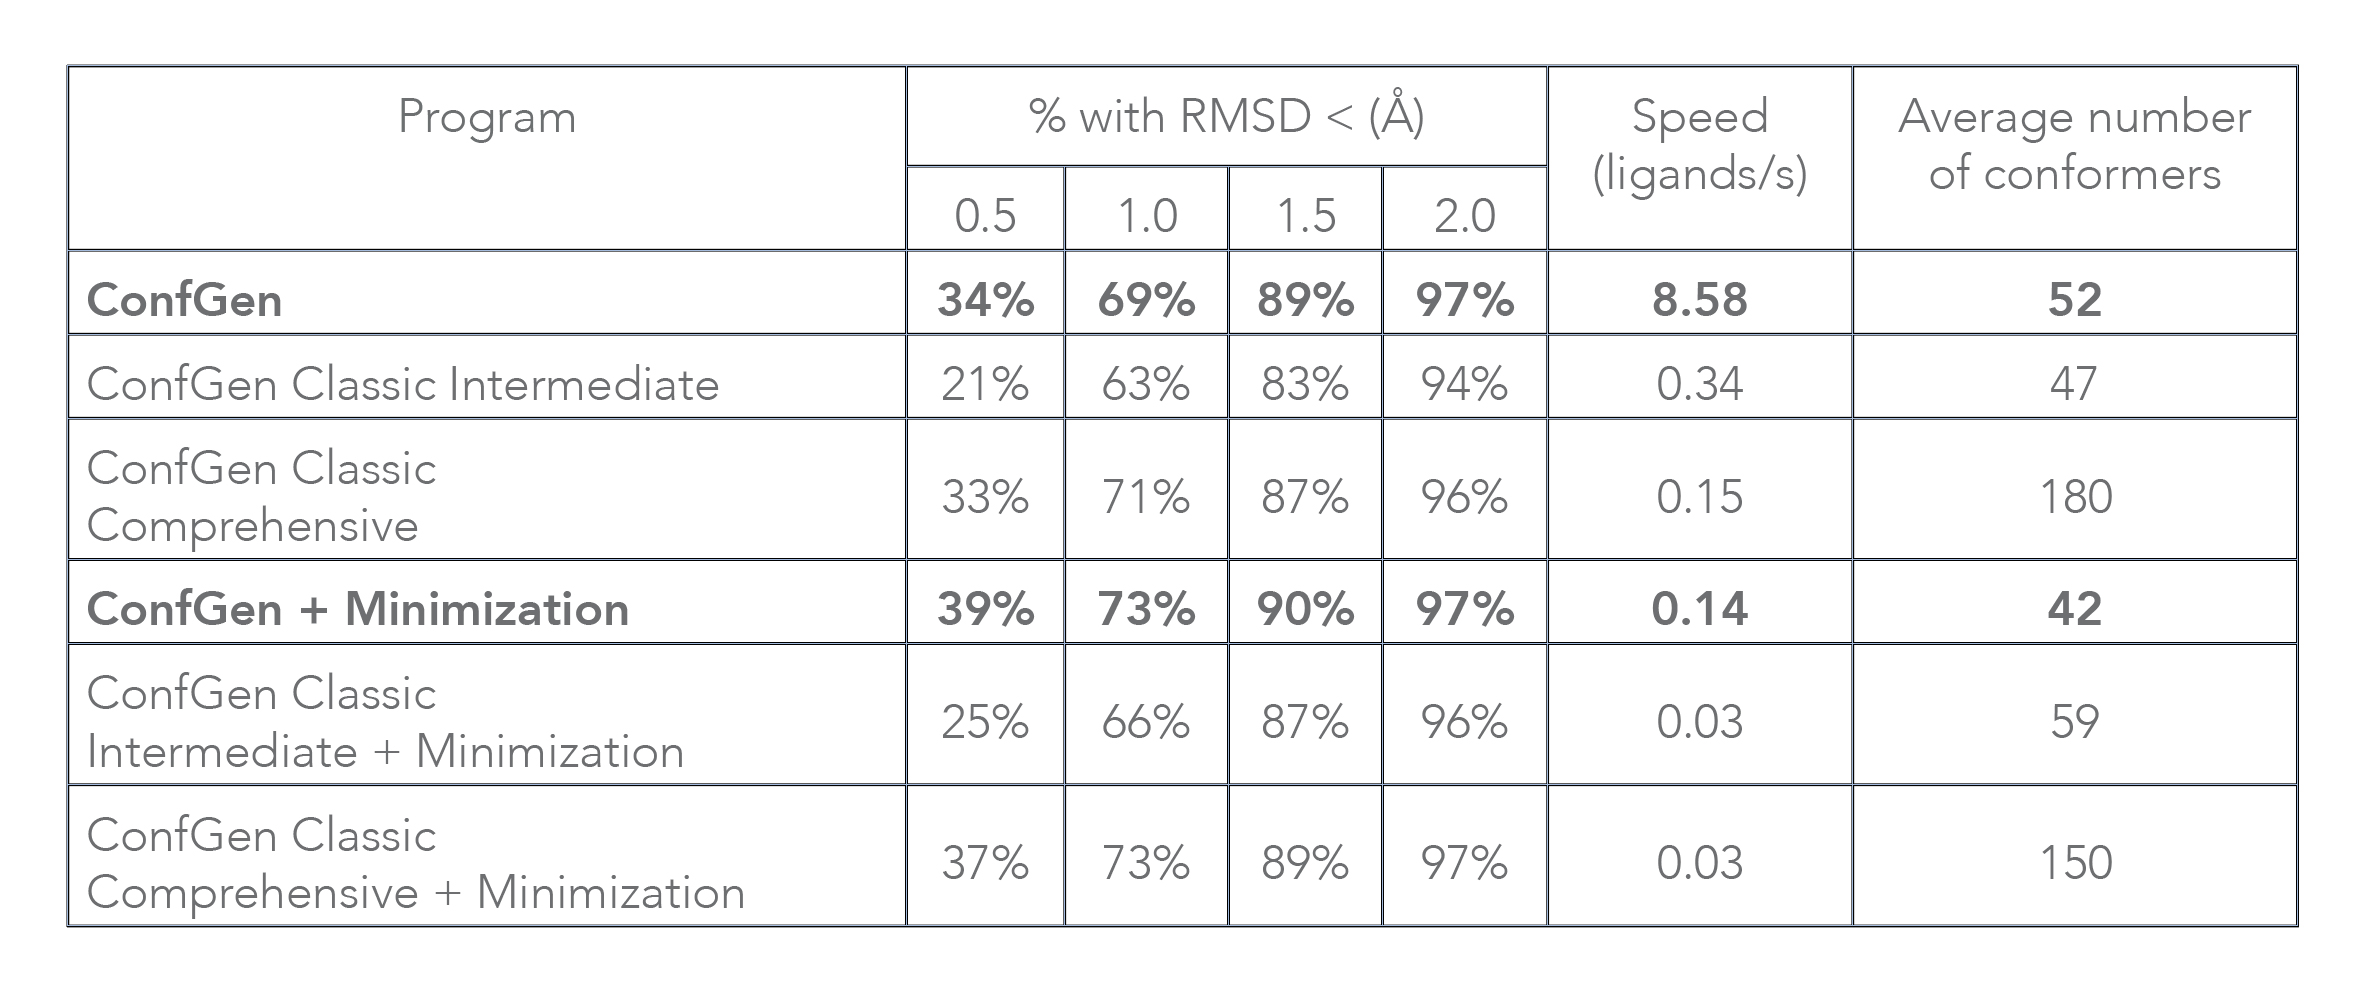
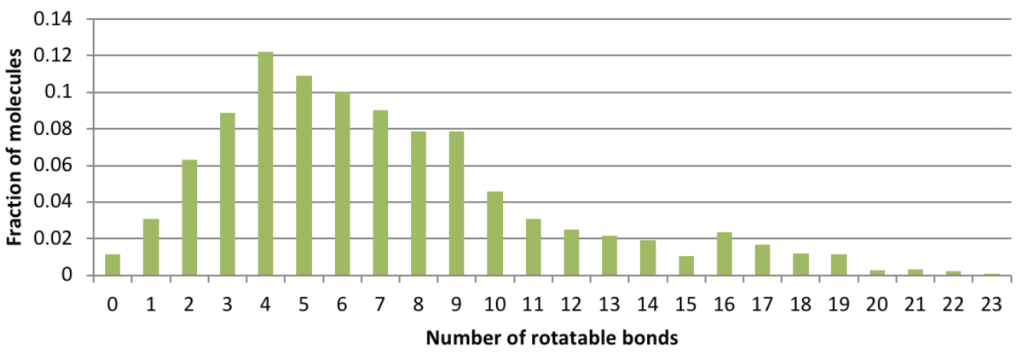
构象生成是一种用于生成化合物多样且低能的3D结构的流程,它是计算机辅助药物设计(in silicodrug design)的关键环节,在基于配体的虚拟药物设计(筛选 )中被广泛应用。为了提高在生成的构象体中检出生物活性构象的效率,并大幅加快构象体的生成速度,Schrödinger 对ConfGen应用程序进行了彻底重写。 如表1所示,新算法的运行速度比ConfGen的旧版本(以下简称“ConfGen Classic”)快约一个数量级,且其生物活性构象检出率与此前ConfGen中计算强度最高的模式相当。 本案例研究使用了 1,904 个配体,这些配体是从高质量的蛋白质-配体晶体结构中提取的。如图 1 所示,该数据集包含了药物样分子中存在的多种多样的官能团,以及各种分子大小和柔性。
Without minimization of output conformers, ConfGen finds the bioactive conformation with an RMSD of < 1.5 Å in 89% of cases compared to 83% and 87% with ConfGen Classic Intermediate and Comprehensive modes, respectively. The new algorithm processes ligands 25 and 57 times faster than ConfGen Classic Intermediate and Comprehensive modes. When minimization of conformers is performed, ConfGen recovers more bioactive conformations with < 1.0 Å RMSD than without minimization. Because minimization acts as the speed bottleneck, the new algorithm is 5 times faster than both ConfGen Classic Intermediate and Comprehensive modes. It should be emphasized that ConfGen is able to achieve bioactive recovery similar to ConfGen Classic Comprehensive in far fewer conformers.
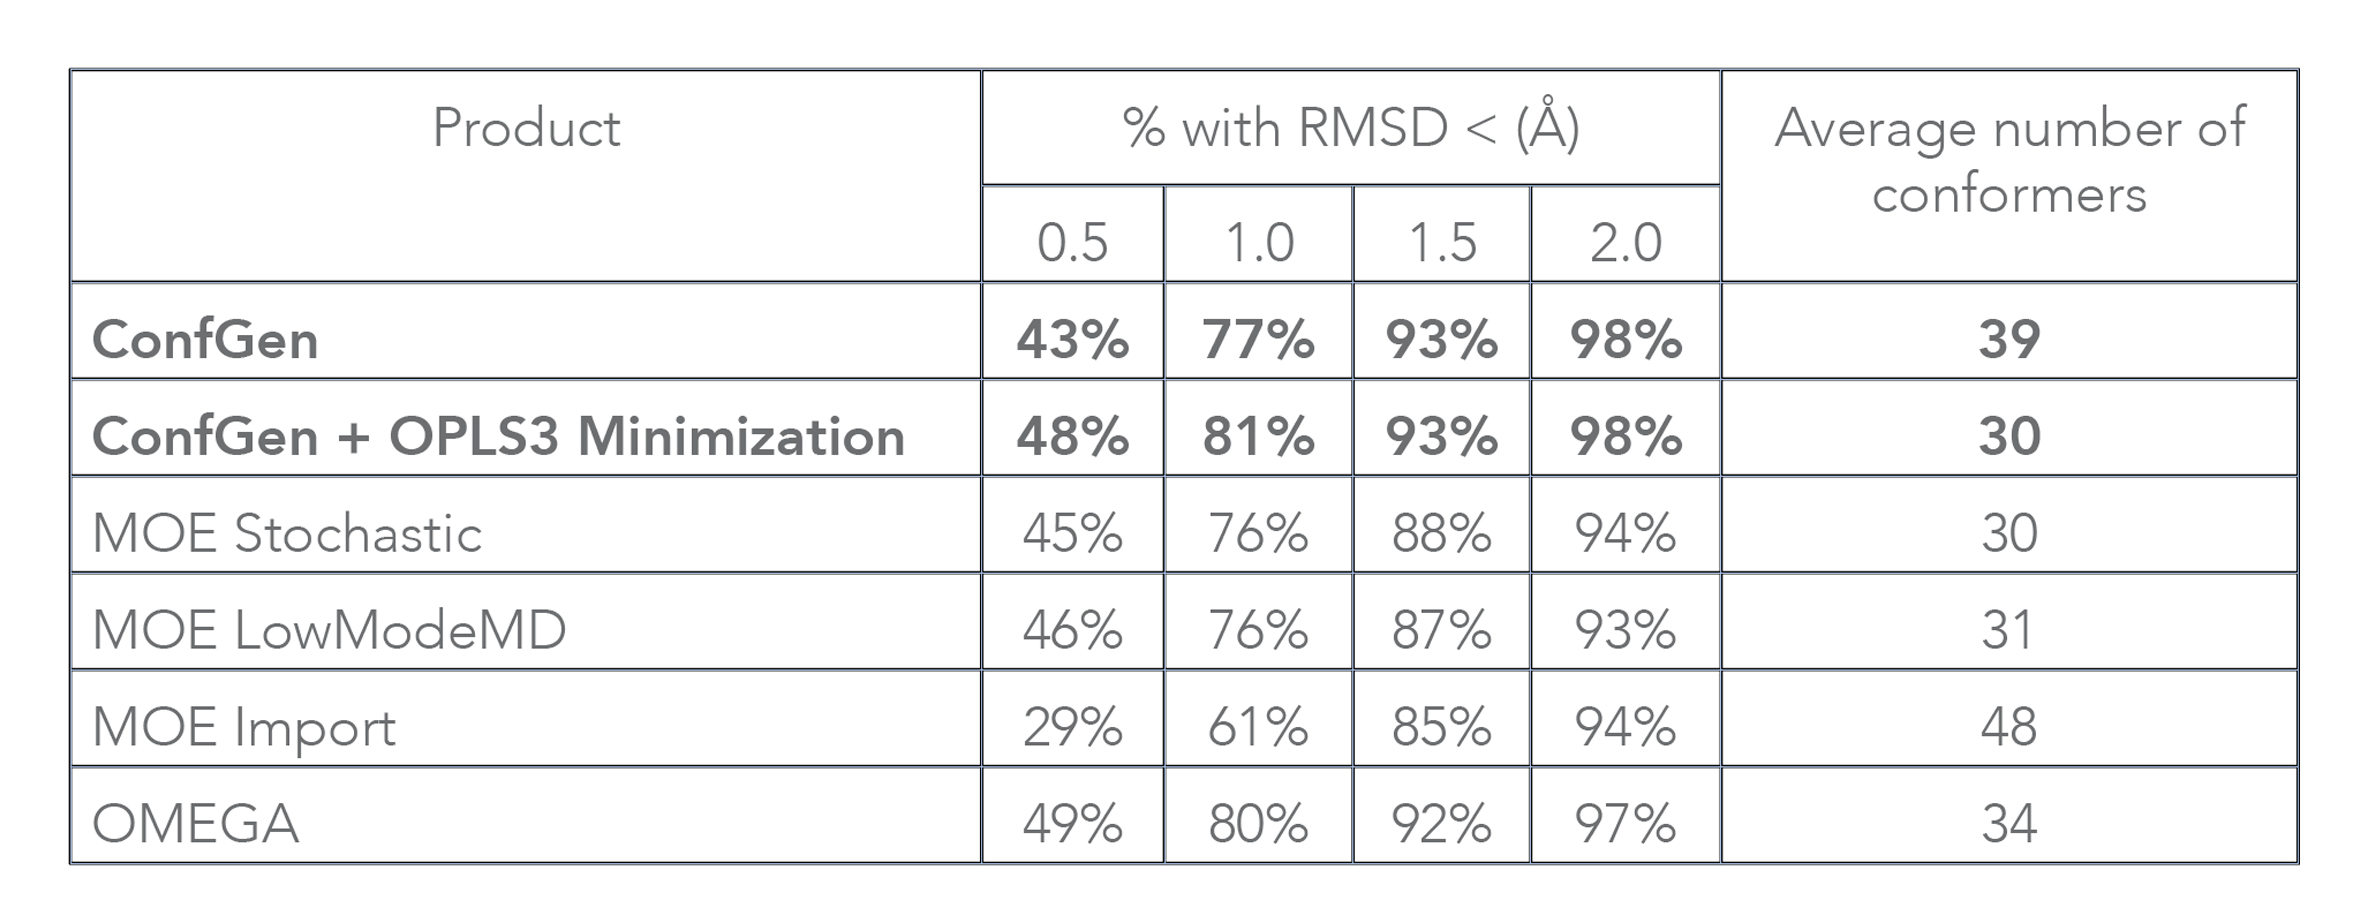
汉堡大学[1]曾利用从PDB中提取的2,859个蛋白质结合配体构象的高质量数据集,对ConfGen和ConfGen Classic以及其他几种商用构象生成器进行了基准测试。在准确性方面,ConfGen程序的表现与OMEGA相当,且总体上优于MOE(见表2)。 需要注意的是,该论文通过每次仅对单个配体运行构象生成程序来评估处理时间,这并不代表典型使用情况。此外,Schrödinger的作业控制系统(该系统可轻松将任务提交至远程队列和主机)产生的开销也被计入 ConfGen 的计时结果中。 剔除这些因素后,当应用于该研究使用的数据集时,ConfGen(Suite 2017-3版本)在不使用优化 的情况下平均每秒可处理15个配体,而使用OPLS3并结合几何优化 时,平均每秒可处理约0.4个配体。这些速度与OMEGA相当,且至少比MOE Import(MOE中最快的方法)快一个数量级。
ConfGen 算法
新的ConfGen算法采用“分而治之”策略,通过三个步骤构建可行的分子构象:(1) 通过断开环外可旋转键,将输入分子划分为片段;(2) 获取所有片段的构象;(3) 通过以各种方式重新连接片段,构建整个分子的构象。
就碎裂而言,以下类型的键被视为不可断裂:环键、双键或三键、与末端原子形成的键,以及常见的“刚性”键,例如酰胺和硫酰胺中的N-C键,以及酯和硫酯中的O-C键。所有其他键在碎裂过程中都会被断裂,并由氢原子取代。图2展示了这一过程。

通过对Zinc数据库[2]的分析,识别出约40,000个模板片段。对每个片段均进行了MacroModel构象 搜索,以生成用于ConfGen搜索的构象库。对于库中未找到的片段,则通过以随机初始原子位置为起点的两阶段优化 过程,实时生成其构象。
优化 的第一阶段使用惩罚函数高效地获得粗略坐标,而第二阶段则使用OPLS3力场对构象进行微调。 该过程将根据片段中sp3中心的数量重复执行若干次。通过对多个公开数据库中化合物的研究发现,使用ConfGen断片规则生成的片段,其低能构象数量最多约为2n⁄2,其中n为sp3中心的数量。 默认情况下,该算法生成的构象数量上限为24个。对于与先前生成的构象相比,重原子RMSD值小于可配置阈值(默认值为0.25 Å)的构象,将被归类为重复项并予以剔除。
在片段的“即时”构象生成第一步中使用的惩罚函数,由一系列旨在产生所需构象特征的项组成:

埃邦兹项是谐波项(每条键对应一项)的和,这些项会对键长偏离其理想值的情况施加惩罚:
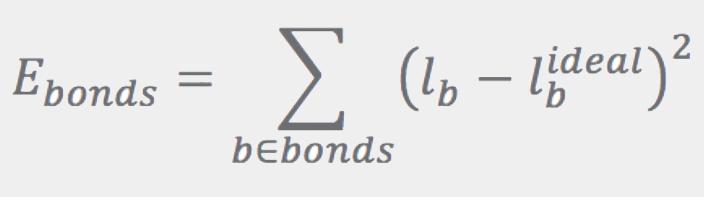
理想键长lbideal 的计算方法如参考文献 [3] 和 [4] 所述。Eangles项的形式与Ebonds 相同,只是求和对象是角度。理想角度是根据原子杂化、连接数和环成员关系等简单规则确定的。Eangles并未直接使用角度,而是采用该角度内第一和第三个原子之间的距离la:
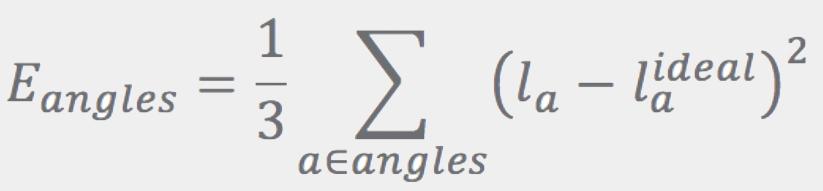
Eplanar和Etetrahedral两项均由对“模板”的求和给出:
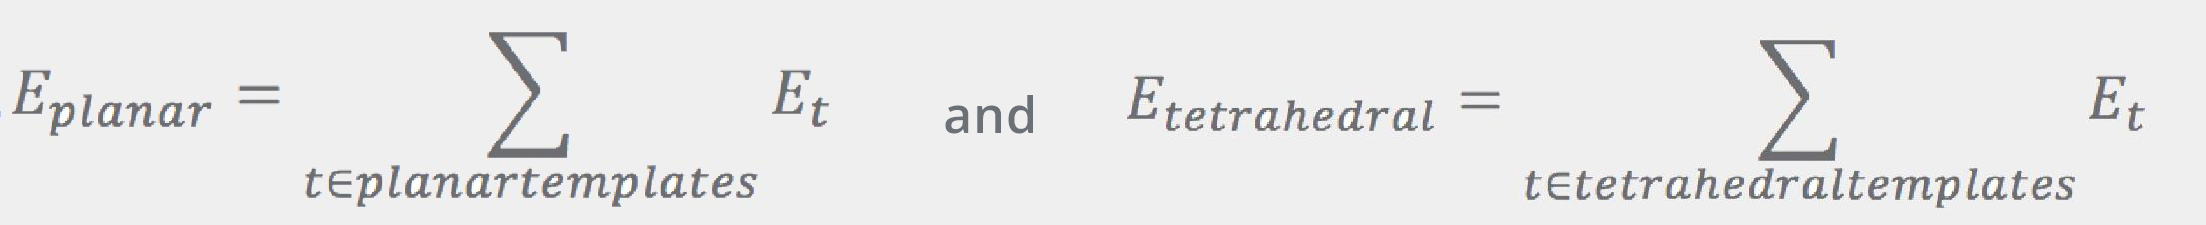
其中Et与该片段原子相对于模板中相应原子的均方根偏差 (RMSD) 成正比:
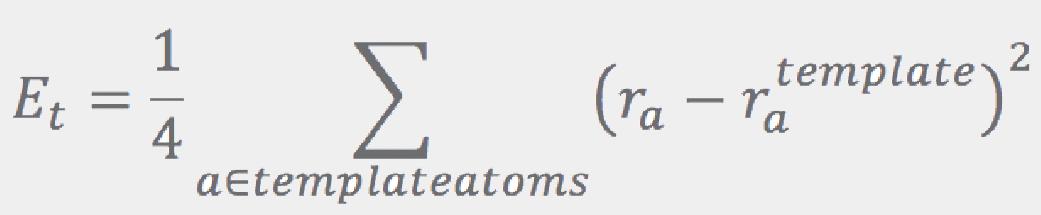
在此,假设模板原子与相应片段的原子重合。ConfGen 使用三种模板:一种用于四面体中心(sp3中心周围有 3 或 4 个原子),另外两种用于sp2原子和双键周围的平面构型。 在所有情况下,理想(模板)位置都是通过理想键长和“完美”角度构建的(平面模板为120°,四面体模板为109.5°)。最后,Erepulsion项由非键合原子对(即不参与Ebonds或Eangles 的原子对)上的短程软“凸起”之和给出:
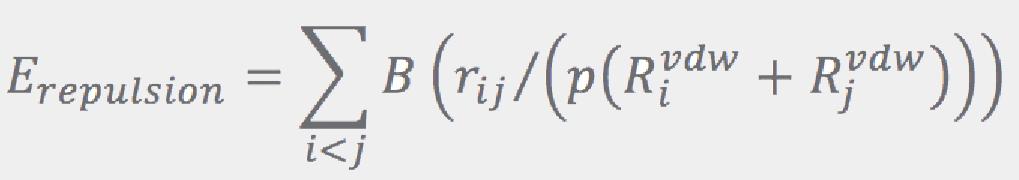
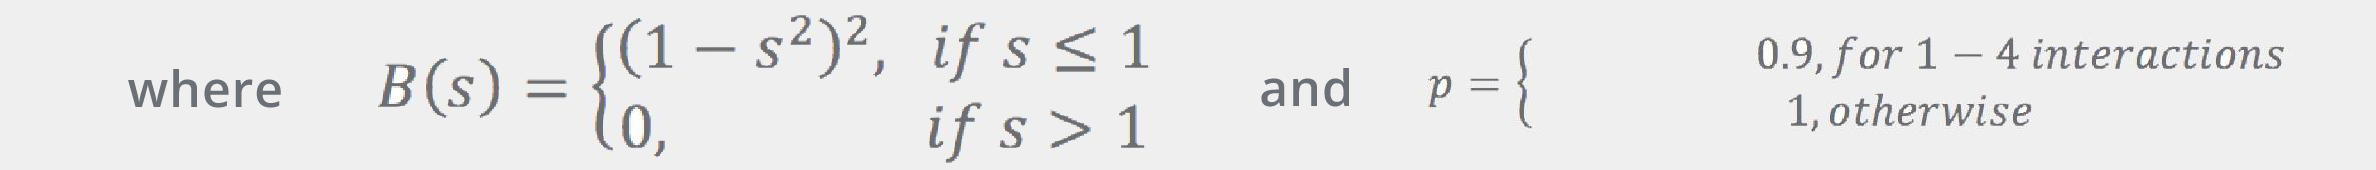
其中rij表示原子间距,RivdW表示范德华半径(引自参考文献[5])。
将片段沿断裂步骤中断的键依次重新连接,每次连接一个键。连接顺序的确定旨在使分子在每个中间步骤中,优先将大小相近的部分连接起来。具体而言,在每个层级,利用两个片段(A和B)的构象来生成组合片段A+B的构象。首先,利用与整个分子匹配的SMARTS 模式,选择特定的二面角,沿A−B键进行采样。 当其中一个(或两个)片段仅有一种构象可用时,首先通过沿新键将其旋转45、60、90和180度,以确定该片段的对称性,并观察是否会产生等效结构。
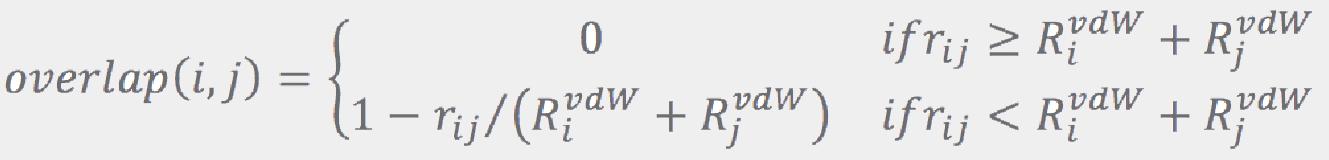
其中rij是原子 i 和 j 之间的距离,RijvdW是参考文献 [5] 中给出的它们的范德华半径。 如果最大重叠度小于可配置的阈值(默认值为 0.5 Å),则该组合将被视为有效的候选构象。该过程将重复进行,直至收集到预设数量的候选构象(默认值为 96 个)。如果没有任何组合通过重叠度测试,则所有组合均被视为有效的候选构象。随后保留预设数量的排名最高的候选构象(默认值为 64 个),其余则被剔除。 对于较大分子,将保留更多的构象:如果可旋转键的数量超过某个阈值(默认值为 9),则控制构象数量的参数(片段的构象数、候选构象数以及每次“合并”后保留的构象数)将按一个与可旋转键数量相关的系数进行增加。
构象的排序是基于Lennard-Jones 6-12非键势的总和(为了加快处理速度,L-J参数取自DREIDING力场[6]值的查表), 与片段间键相关的特设二面角惩罚项,以及通过增强特定的1-4相互作用来促进环的赤道(相对于轴向)连接构型的贡献项。 将逐渐增大的片段组合在一起,并对恢复的键进行多种取向采样,这一过程将持续进行,直至整个分子被重建。仅对小于特定阈值的分子(默认情况下,重原子或极性氢原子少于32个)进行重复构象消除,因为该过程耗时较长,且对大分子影响甚微。
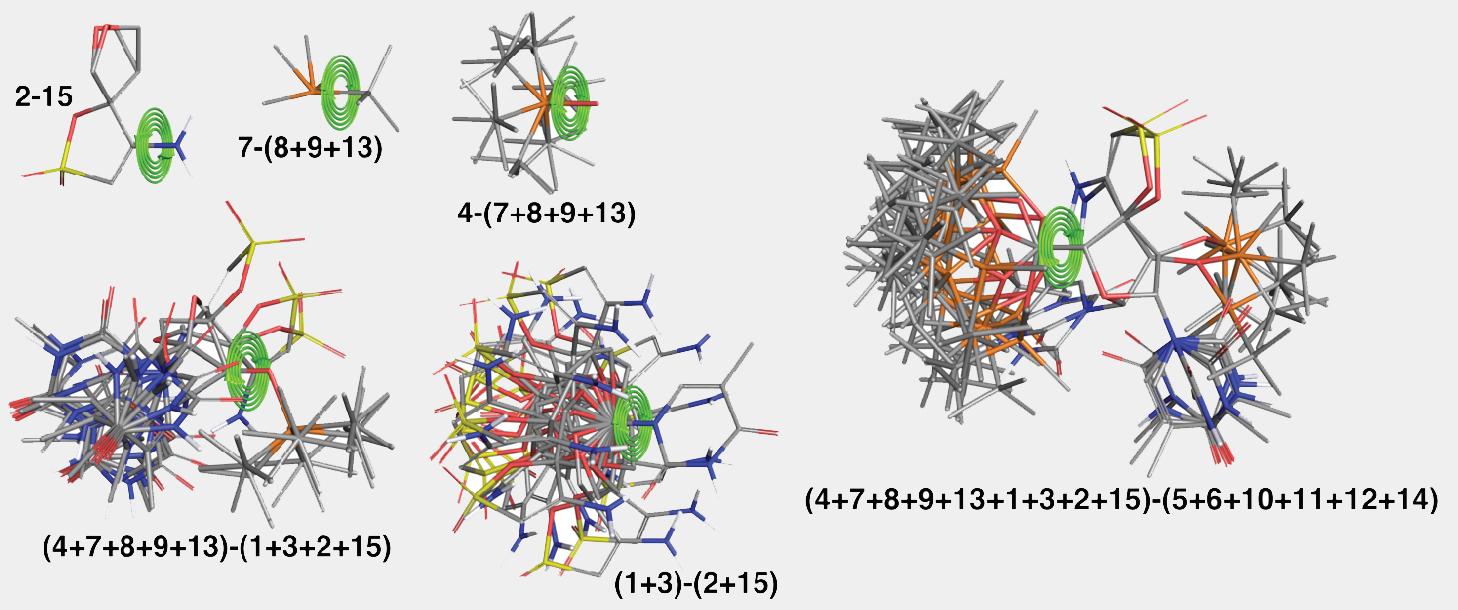
图2和图3展示了该算法针对PDB结构代码为3QO9的配体的关键步骤。如图2所示,该结构被划分为十五个片段。只有标记为“2”的片段具有多个低能构象。该算法会选择片段组装的顺序,以尽量减少需要检查是否发生重叠的原子对数量。 对于该结构,组装顺序如下:1+3、2+15、5+6、9+13、12+14、8+(9+13)、11+(12+14)、(1+3)+(2+15)、7+(8+9+13)、 10+(11+12+14),4+(7+8+9+13),(5+6)+(10+11+12+14),(4+7+8+9+13)+(1+3+2+15),(4+7+8+9+13+1+3+2+15)+(5+6+10+11+12+14)。许多组装步骤涉及简单的片段,例如 1+3、5+6、12+14 等,最终形成一个仅具有单一独特构象的合并片段。图 3 展示了组装算法的示意性阶段。
可以使用几个 ConfGen 参数来控制计算速度与生物活性构象恢复之间的权衡。其中最重要的两个参数是:是否使用 OPLS 力场优化构象体的几何结构,以及程序预计生成的构象体数量。研究发现,在最小化过程中使用默认值 10(介电常数 )比使用 1 更能有效生成生物活性构象。图 4 展示了一个实际案例。 除了消除不良的原子接触外,几何优化(优化 )通常还能略微提高生物活性构象的恢复率(生物活性构象 )(见表1)。然而,几何优化(优化 )的运行速度比不进行最小化计算慢约20倍。此外,几何优化(优化 )往往会减少构象变体的数量;这可能先导化合物 ,从而缩短后续使用这些构象的计算所耗费的时间。
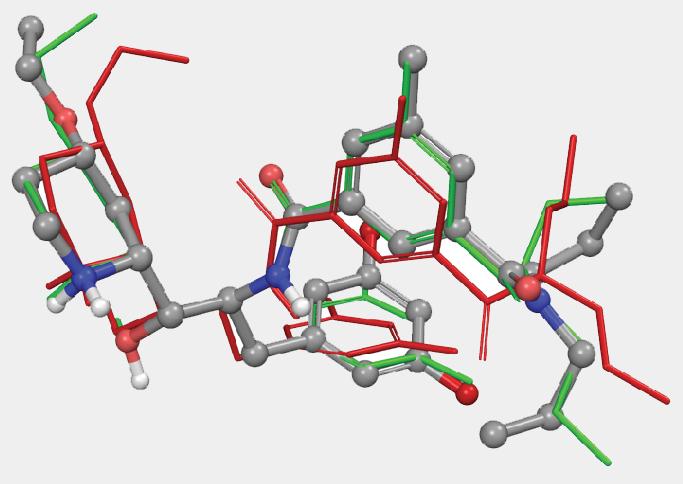
另一个控制速度与质量权衡的参数是每个输入配体应生成的构象变体数量(-n 命令行选项):该参数的数值越大,通常会带来更好的构象多样性。图 4 展示了来自 2QP8 PDB 条目(1.5Å 分辨率)的配体的示例:使用默认的模拟 设置时,最接近生物活性构象 的构象变体的 RMSD 为 1.3Å(红色)。 如果将构象的最大数量从64(默认值)增加到256,并启用基于OPLS3力场的几何优化(优化 ),则RMSD将降至0.6Å(绿色)。
结论
集成式 鉴于其卓越的速度以及能够重现低RMSD生物活性构象的能力,ConfGen是基于配体的虚拟筛选 生成构象的理想解决方案。它与 Maestro Schrödinger的基于配体的药物发现工具中 ,包括 Phase,该工具能够轻松创建数据库,以实现基于配体的快速虚拟筛选 。与所有Schrödinger 产品一样,ConfGen也在不断优化和改进,因此,尽管本文所述的更新与之前的版本相比代表了重大进步,但它们也将作为未来增强功能的基础。
参考文献
-
Friedrich, N.O. 等,《商用构象集合生成器的基准测试》,
《J. Chem. Inf. Model》,2017年,第57卷第11期,第2719-28页。
-
Irwin, J.J.;Sterling, T.;Mysinger, M.M.;Bolstad, E.S.;Coleman, R.G.,《ZINC:一款用于生物化学探索的免费工具》,
《J. Chem. Inf. Model.》,2012年,第52卷第7期,第1757-68页。
-
Pyykkö, P.; Atsumi, M.,《1-118号元素的分子单键共价半径》,
《化学》,2009年,第15卷第1期,第186-197页。
-
Pyykkö, P.;Atsumi, M.,《Li-E112 元素的分子双键共价半径》,
《化学》,2009年,第15卷(第46期),第12770-9页。
-
阿尔瓦雷斯,S.,《范德华区域的制图》,
《道尔顿交易》,2013年,第42卷第24期,第8617-36页。
-
Mayo, S.L.;Olafson, B.D.;Goddard, W.A.,《DREIDING:一种用于分子模拟的通用力场》,
《物理化学杂志》,1990,94,8897-8909。