FEB 2, 2022
現代のヒット曲発見のトレンド:超大型スクリーンが機械学習を活用する方法


登壇者:
マット・レパスキー
上級副社長
要旨:
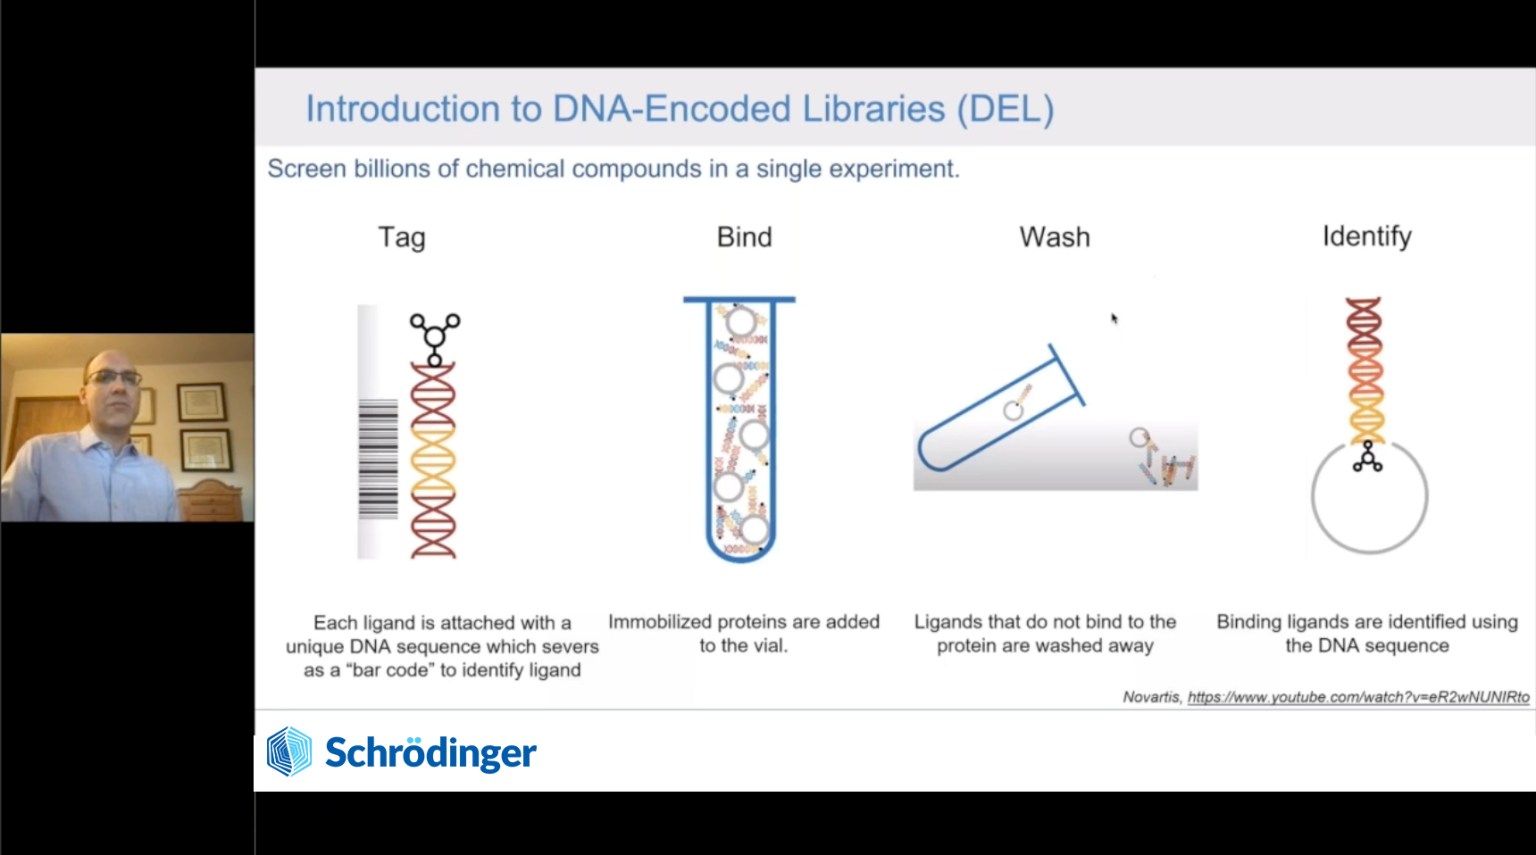
従来の構造 を用いたバーチャルスクリーニングは、プロジェクトを推進するための多様なヒット化合物の発見において成果を上げてきたものの、ヒット率、ヒット化合物の化学型の多様性、探索可能な知的財産(IP)スペース、および未最適化のヒット化合物の活性 (化合物の活性化能)については、依然として大幅な改善の余地がある。 ベンダーが提供するオンデマンドで合成可能な超大規模ライブラリにより、購入可能な化合物 空間は約100倍に拡大し、現在では数十億の化合物を網羅するようになったが、DNAエンコードライブラリ(DEL)はさらに大規模なものとなり得る。数十億もの化合物を含むこれらのはるかに広大な化学空間をスクリーニングするため、数十億の化合物 以上のライブラリに対する仮想スクリーニングおよびDELスクリーニングを通じて、新規ヒット化合物を容易かつ費用対効果高く発見できる、2つの機械学習を活用したアプローチの結果について述べる。 DNAエンコードライブラリ(DEL)は、数十億の合成化合物のスクリーニングを可能にするが、実験上の偽陰性および偽陽性の発生率が高いため、その活用には限界がある。実験的なDEL結果を用いて学習させた機械学習を採用することで、偽陰性率を大幅に低減しつつ、より好ましい物性空間において副生成物を特定できることを実証した。正確なドッキングスコアリング関数を用いた効率的で外挿的な化合物空間 探索を可能にするため、AutoQSAR/DC機械学習とGlide SPドッキングを学習器として用いたアクティブラーニングベースの手法を開発した。 1億から10億の化合物(化合物 )を対象としたアクティブラーニングによるスクリーニング(Glide )の結果、ライブラリのサブセットに対する総当たり法(brute force)によるスクリーニングと比較して、ヒットの化学的多様性とGlideScoreが向上したことが示された。これら2つの新しい手法の結果とコストから、10億の化合物(化合物 )を対象としたスクリーニング(ライブラリ )が、現在一般的に採用されている小規模な従来のスクリーニングに取って代わる可能性があることが示唆される。